
Pięć trendów z czerwca. Pół roku później sprawdzam, które przetrwały
W czerwcu napisałem poradnik o pięciu trendach w projektowaniu stron pod agentów AI. Dwa się obroniły, trzy wymagają korekty, a jeden format, który polecałem, nigdy nie zaistniał.
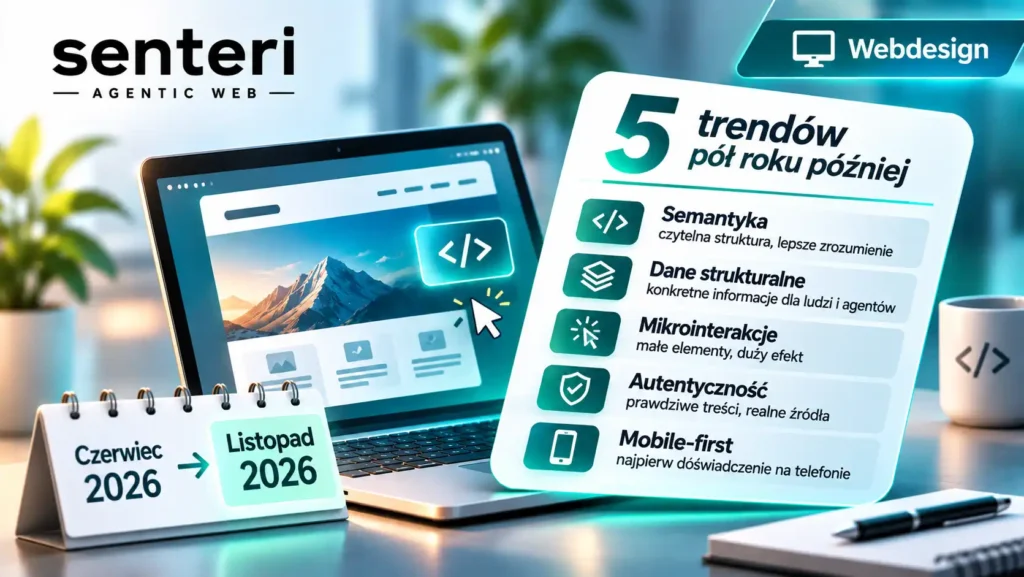
W czerwcu przygotowałem dla Studia iFOX poradnik „Design 2026: Agent-Ready Guide”: pięć trendów, które miały zmienić projektowanie stron w czasach agentów AI, tabela z oceną ich wpływu i ośmiopunktowa checklista. Pół roku w tej dziedzinie to dużo, więc sprawdzam własne tezy, łącznie z tymi, które się nie obroniły.
Trend 1: semantyka. Obroniła się, ale z innego powodu
W czerwcu pisałem, że AI nie widzi designu, tylko strukturę, więc strony z logiczną architekturą są częściej cytowane. Pierwsza część była uproszczeniem: niektórzy agenci działają na zrzutach ekranu i widzą stronę jak człowiek. Druga część okazała się słuszna, ale z ważniejszego powodu niż cytowania.
Agenci przeglądarkowi, którzy mają na stronie coś zrobić, czytają przede wszystkim drzewo dostępności: tę samą strukturę, z której korzystają czytniki ekranu. Google pisze to wprost w dokumentacji swojego audytu gotowości na agentów: dobrze zbudowane drzewo dostępności to podstawowy sposób, w jaki agenci AI rozumieją stronę. Semantyka nie jest już więc kwestią lepszej widoczności. Decyduje o tym, czy agent w ogóle może cokolwiek na stronie zrobić.
Problem w tym, że z tym fundamentem jest coraz gorzej. W lutym 2026 błędy dostępności miało 95,9% najpopularniejszych stron głównych, po raz pierwszy od sześciu lat więcej niż rok wcześniej.
I jeszcze jedna lekcja z półrocza: przeglądarka agentowa ChatGPT Atlas przetrwała dziewięć miesięcy. OpenAI ogłosiło jej zamknięcie 9 lipca, a 9 sierpnia przestała działać. Kto projektowałby stronę pod jednego konkretnego agenta, budowałby na piasku. Semantyczny HTML działa niezależnie od tego, który agent przyjdzie jutro.
Trend 2: dane strukturalne. Częściowo
Schema.org nie okazała się przepustką do cytowań, którą obiecywała połowa branży. Badania są niejednoznaczne. Część pokazuje wyraźny związek z cytowaniami, zwłaszcza w Google AI Overviews. Kontrolowane badanie Ahrefs, które śledziło strony przed dodaniem JSON-LD i po nim, nie znalazło istotnej zmiany w ChatGPT. Schema pomaga, ale nie zastępuje treści, i najwięcej daje stronom, których maszyny jeszcze nie znają.
Z llms.txt jest gorzej. Liczba takich plików wzrosła w rok prawie dziewięciokrotnie, ale w maju 97% z nich nie dostało ani jednego zapytania. Najczęściej czytają je narzędzia SEO, a nie agenci AI. W moim majowym raporcie AI-Readiness llms.txt miało 23% polskich stron. Nie szkodzi, ale nie warto na nim budować.
Do tego jedna rzecz, którą muszę odwołać. W czerwcowym poradniku wymieniłem agent-access.json jako element świata agentów i automatyzacji. Taki standard nie zaistniał. W pierwszej połowie 2026 powstawało tyle propozycji formatów dla agentów, że dziś nie umiem nawet wskazać, gdzie widziałem tę koncepcję. Podobne pomysły wciąż krążą po checkerach gotowości jako „wschodzące standardy”: agents.json według strony, która go opisuje, nie jest standardem żadnej organizacji i ma kilka konkurujących wariantów. Lekcja: szybkość, z jaką opisuje się nowości, to nie to samo co ocena, które z nich przetrwają.
To, co się pojawiło zamiast tego, idzie dalej niż dane: WebMCP pozwala stronie wystawić agentowi gotowe narzędzia. Testy w Chrome trwają od wersji 149, a Google włączył już WebMCP do swojego audytu gotowości na agentów. O tym, dlaczego uważam to za problem, mimo że sam pomysł jest słuszny, piszę osobno: Ogon, który udaje fundament.
Trend 3: mikrointerakcje. Do korekty
W czerwcu pisałem, że mikrointerakcje komunikują się także z agentami. To prawda tylko wtedy, gdy stan jest zapisany w HTML: przycisk naprawdę wyłączony, a nie tylko wyszarzony, rozwinięta sekcja oznaczona jako rozwinięta, komunikat o błędzie w miejscu, które czytnik ekranu ogłosi. Animacja, której nie ma w drzewie dostępności, dla agenta czytającego strukturę nie istnieje. Korekta brzmi więc: nie mikrointerakcje, tylko stan interfejsu zapisany w kodzie.
Trend 4: autentyczność. Dla ludzi tak, dla maszyn inaczej
Prawdziwe zdjęcia zamiast stockowych nadal budują zaufanie ludzi. Agentom nic nie mówią. Dla maszyn autentyczność oznacza co innego: czy wiadomo, kto stoi za treścią. Przekonałem się o tym na własnym projekcie. Duch Stron trafił do odpowiedzi modeli AI w cztery dni po publikacji, ale modele przypisały go studiu, a nie autorowi. Dowody, których maszyna nie umie przypisać właściwej osobie, są dla niej dowodami kogoś innego. Autentyczność dla maszyn to podpisane autorstwo.
Trend 5: mobile-first. Dla ludzi tak, dla agentów inaczej, niż myślałem
Teza, że strony mobile-first są „gotowe na agentów”, była na wyrost: agentom wielkość ekranu jest obojętna, a jedno z badań nie znalazło związku między szybkością ładowania a cytowaniem w AI Overviews. Jedna rzecz z tego obszaru okazała się jednak ważna dla agentów w nieoczekiwany sposób: stabilność układu. Google mierzy ją w audycie dla agentów, bo elementy, które przesuwają się w trakcie ładowania, sprawiają, że agent klika w złe miejsce. Tak jak człowiek, tylko bez cierpliwości.
Czego w czerwcu zabrakło
Pierwsza rzecz to decyzja o dostępie. Boty to już ponad połowa ruchu HTML w sieci, a od 15 września Cloudflare domyślnie blokuje crawlery treningowe i agentów na stronach z reklamami. Pytanie „czy wpuszczać agentów i na jakich warunkach” stało się decyzją projektową, a mój poradnik go nie zadawał. W majowym raporcie sygnały, którymi strona mówi, do czego wolno używać jej treści, miało 2,4% polskich stron. Większość nie zdecydowała, bo nie wie, że ma wybór.
Druga rzecz to zmiana, która nie dotyczy kodu, tylko zawodu. Przez ten rok obserwowałem trzy fazy. Najpierw zachwyt: AI robi strony. Głosili go zarówno twórcy stron, jak i ludzie, którzy nigdy się tym nie zajmowali. Potem olśnienie: AI robi strony tak ładne jak większość stron w internecie, do tego szybko, a przy okazji z poprawną semantyką, schemą i dostępnością. Potem pytanie: czym w takim razie ma się zajmować webdesigner, skoro klient zna swoją branżę i z AI zrobi stronę sam, a webdesigner zna tylko tę część, która dotyczy budowy strony? I wreszcie czwarta faza, którą widzę teraz: stronę już mam, ale wracam do swojego biznesu. Kto się nią zajmie, kto ją utrzyma, kto ją wypromuje?
Jest tu ciekawe napięcie z danymi. Skoro AI robi strony poprawne semantycznie, to dlaczego dostępność w sieci się pogorszyła? Jedna z analiz wskazuje jako możliwą przyczynę właśnie szybsze, wspomagane przez AI budowanie stron, choć sama zaznacza, że nie da się tego udowodnić. Możliwość zrobienia poprawnej strony to nie to samo co zrobienie jej poprawnie i utrzymanie w tym stanie.
I tu, moim zdaniem, przesuwa się rola webdesignera: od budowania do opieki. Od pytania „jak to zrobić” do pytań „czy to nadal działa”, „kogo wpuszczamy”, „czy maszyny wiedzą, kto za tym stoi”.
Checklista na 2027
Poprawiona wersja czerwcowej listy, w kolejności, która ma znaczenie:
- Natywne elementy HTML i nazwa dla każdej kontrolki: przycisk jest przyciskiem, pole ma etykietę. Sprawdź drzewo dostępności swojej strony.
- Treść i ceny w HTML, widoczne bez JavaScriptu.
- Stan interfejsu w kodzie, a nie tylko w animacji.
- Stabilny układ: nic nie przeskakuje podczas ładowania.
- Schema.org zgodna z tym, co na stronie, zwłaszcza dla organizacji i autora.
- Podpisane autorstwo: kto, skąd i z linkami, które to potwierdzają.
- Świadoma decyzja o dostępie: robots.txt, sygnały treści, ustawienia CDN.
- WebMCP tylko tam, gdzie HTML nie wystarcza, i dopiero po punktach od 1 do 7.
Z czerwcowego poradnika przetrwało najlepiej to, co służy jednocześnie ludziom i maszynom. Nie przetrwały formaty przeznaczone tylko dla maszyn. To chyba najważniejszy wniosek z tego półrocza.
Źródła
- Studio iFOX: Design 2026: Agent-Ready Guide (PDF, czerwiec 2026)
- Chrome for Developers: A developer toolkit to make your website agent-ready
- Search Engine Journal: The accessibility tree is how AI agents read your site
- AI Toolbox: ChatGPT Atlas Browser: Shutdown and What Replaced It
- Analyzify: Does schema markup help AI citations? What studies found
- PPC Land: llms.txt adoption rises 8.8x but 97% of files get zero AI requests
- Webflux: Polski Raport AI-Readiness 2026, Edycja I
- The Decoder: Cloudflare replaces its blanket AI bot block with granular controls
- PPC Land: Cloudflare stops charging AI per crawl and starts paying per answer