
Bałagan, który działa. Co doba bez poczty Microsoftu mówi o firmach i państwach
Awaria Microsoft 365 z 12–13 listopada 2026 od środka: cztery przyczyny, kaskada po świecie i lekcja dla firm z ERP. Liczy się to, co pada razem.
W piątek 13 listopada w Wielkiej Brytanii szpitale odwoływały część operacji, a apteki ostrzegały pacjentów, że recepty mogą przyjść z opóźnieniem. W tym samym czasie kilka polskich firm, którymi się opiekuję, zgłosiło jeden problem: w OneDrive nie działała wyszukiwarka. Dostały odpowiedź, że to awaria Microsoftu, i pracowały dalej.
To była ta sama awaria. Ten sam defekt, te same serwery, ta sama doba. Różnica nie wynikała z tego, kto miał lepszego dostawcę ani kto bardziej ufał chmurze. Wynikała z tego, ile rzeczy w danej organizacji padło naraz, kiedy padła jedna.
Ten tekst jest o tej różnicy. Ale żeby do niej dojść, trzeba najpierw zobaczyć, jak duży stał się sam dostawca i jak jedna drobna wada w jego środku rozlała się na cały świat.
Jeden dostawca, siedemdziesiąt cztery kraje
Awaria zaczęła się 12 listopada o 17:20 czasu polskiego i trwała niemal dobę. W ciągu godziny użytkownicy z 74 krajów i terytoriów zgłaszali problemy w serwisie Downdetector, a w szczycie samych zgłoszeń o Outlooku było około 130 tysięcy, głównie z USA (GSMonline). Z Microsoft 365 korzysta ponad 430 milionów ludzi; ilu z nich odczuło awarię, nie wiadomo (Polsat News).
Ważniejsze od liczb jest to, kto stanął:
- Ochrona zdrowia. W Wielkiej Brytanii apteki miały problem z kontaktem z przychodniami, bo leżała poczta NHS; brytyjskie stowarzyszenie farmaceutów ostrzegało przed opóźnieniami recept (CNN). Część operacji odwołano, bo kalendarze szpitali działają na systemach Microsoftu (Wikipedia). NHS England przeszło na inne systemy albo na papier (Nursing in Practice).
- Państwo. Brytyjska policja nie przyjmowała zgłoszeń przez internet i odsyłała na numery 101 i 999 (Times & Star). Problemy miał rząd Norwegii i japońskie ministerstwa (Bankier), a na Filipinach spowolniła praca sądów (CNN).
- Gospodarka. Firmy, linie lotnicze i agencje rządowe na całym świecie (Forbes).
Jeszcze dwadzieścia lat temu poczta firmy była jej własnym problemem: serwer w szafie, administrator, kopia zapasowa. Dziś dla setek milionów ludzi poczta, kalendarz, pliki i komunikator to jedna usługa jednego dostawcy. Dostawca tej skali przestał być po prostu firmą informatyczną. Stał się częścią infrastruktury, od której zależą szpitale i sądy, tak jak od sieci energetycznej. Różnica polega na tym, że sieć energetyczna ma regulatora, rezerwy i obowiązek dostaw, a poczta w chmurze ma umowę licencyjną i gwarancję dostępności liczoną w procentach.
Cztery rzeczy, z których żadna osobno nie była groźna
Microsoft opublikował 20 listopada końcowy raport poincydentalny, dostępny dla administratorów w centrum administracyjnym Microsoft 365. Wynika z niego, że awarię wywołały cztery czynniki naraz.
- Uśpiony błąd w Windows. Na serwerach bramowych, przez które przechodzi ruch do Exchange Online, działała aktualizacja wdrażana od lipca. Pod dużym obciążeniem wewnętrzny proces Windows blokował sam siebie, aż serwer wyczerpywał procesor i pamięć i przestawał odpowiadać. Błąd ujawniał się tylko na nowszym sprzęcie z większą liczbą rdzeni. Microsoft podkreśla, że ani błąd, ani aktualizacja nie dotyczą Windows w zwykłych wdrożeniach, więc serwery w firmach nie są nim zagrożone.
- Mniej serwerów niż zwykle. Prawie 14% przepustowości bram było wyłączone w ramach rutynowego wdrażania nowej wersji usługi. Zapas był na to przygotowany.
- Przełączenie awaryjne Teams. Kilkanaście godzin wcześniej, o 2:07 w nocy czasu polskiego, problem z trasowaniem we wschodnich USA uruchomił automatyczne przeniesienie ruchu Teams na zapasową bramę. Ta brama obsługiwała też Exchange Online. Przez około 16 godzin nic się nie działo.
- Szczyt ruchu w Ameryce Północnej. Gdy w USA zaczął się dzień pracy, wszystkie trzy poprzednie czynniki spotkały się z największym obciążeniem doby.
Każdy z tych czynników był zwyczajny. Konserwacja, przełączenie awaryjne i poranny szczyt zdarzają się codziennie i według Microsoftu razem mieszczą się w normalnych warunkach pracy. Bez uśpionego błędu nic by się nie stało. Z nim wystarczyło, żeby spotkały się w jednym miejscu.
Zabezpieczenie, które rozwiozło awarię po świecie
Najciekawsza część raportu nie dotyczy samego błędu, tylko tego, jak się rozprzestrzenił. Zrobiły to mechanizmy, które miały chronić usługę.
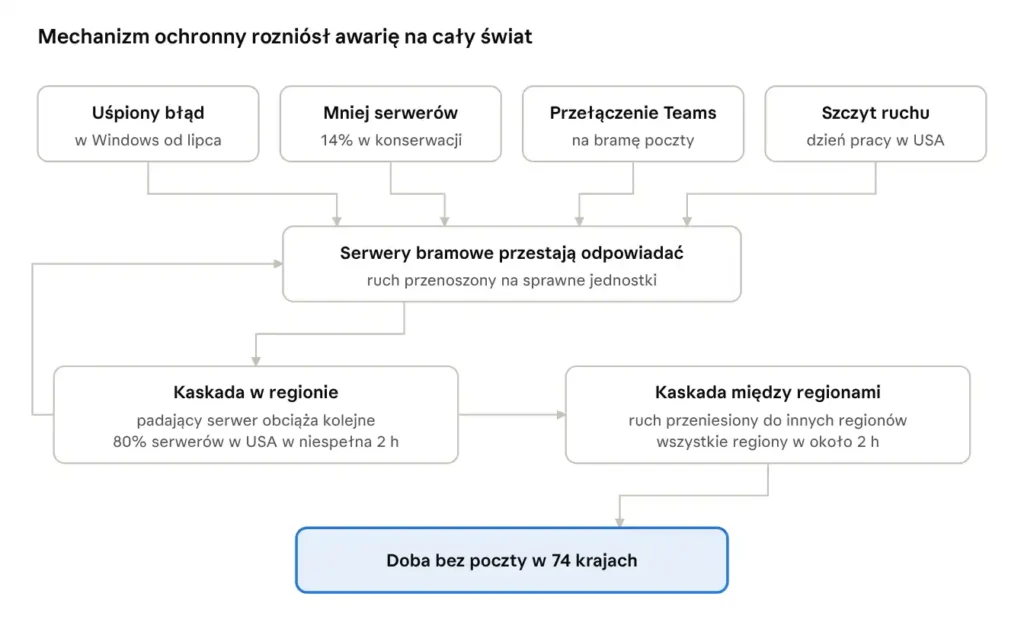
Każdy z czterech czynników był codzienny. Awarię na świat rozniósł dopiero mechanizm, który przenosi ruch z niesprawnych serwerów na sprawne.
Brama Microsoftu składa się z tysięcy jednostek przepustowości. Gdy któraś przestaje odpowiadać, system automatycznie przenosi jej ruch na sprawne jednostki w tym samym regionie. Na co dzień właśnie to sprawia, że pojedyncza awaria sprzętu jest niezauważalna. Tym razem sprawne jednostki dostawały dodatkowy ruch, większe obciążenie budziło w nich ten sam błąd, więc padały i oddawały ruch kolejnym. W niespełna dwie godziny ponad 80% serwerów bramowych w Ameryce Północnej przestało odpowiadać.
Gdy regionowi zabrakło przepustowości, ten sam mechanizm zrobił krok wyżej: przeniósł ruch do innych regionów. Tam stawały te same serwery z tym samym błędem. Po kolejnych około dwóch godzinach awaria obejmowała każdy region na świecie, także Europę.
Drugi mechanizm ochronny zadziałał jeszcze wcześniej. Microsoft utrzymuje dwa niezależne, różnie zbudowane systemy bram właśnie po to, żeby awaria jednego nie dotykała usług na drugim. Przełączenie awaryjne Teams przeniosło jednak ruch komunikatora na bramę poczty, i to na całym świecie, choć problem dotyczył jednego regionu. Dwie usługi, które miały padać osobno, zaczęły dzielić jeden los.
Nic tu nie zadziałało wbrew projektowi. Oba mechanizmy zrobiły dokładnie to, do czego je zbudowano. Problem w tym, że zabezpieczenie bez izolacji jest też drogą, którą awaria przechodzi dalej.
Dlaczego naprawa trwała dobę
Administratorzy, którzy tej nocy śledzili komunikaty Microsoftu, widzieli kolejne próby i kolejne niepowodzenia. Wieczorem firma pisała, że nie znalazła ostatnich zmian powiązanych z początkiem awarii. Około północy przyznała, że dotychczasowe działania nie przyniosły oczekiwanej ulgi. Raport wyjaśnia, dlaczego.
- Przyczyna miała cztery miesiące. Zmianę, która wprowadziła błąd, wdrażano od lipca. Przeszła bezpieczne wdrożenie i ponad trzy miesiące działała na całym świecie bez problemów. Testy obciążeniowe robiono na starszym sprzęcie z mniejszą liczbą rdzeni, na którym błąd prawie się nie ujawnia. Szukanie winnego wśród świeżych zmian nie mogło go znaleźć.
- Zwykłe zabezpieczenia nie działały. Na świeżą zmianę są gotowe odpowiedzi: wstrzymać wdrożenie, wycofać je, wyłączyć nową funkcję. Na zmianę sprzed czterech miesięcy, obecną już w całej flocie serwerów, żadna z nich nie działała szybko.
- Naprawione serwery od razu padały. Każdy serwer przywracany do pracy natychmiast zalewał ruch klientów, którzy od godzin próbowali się połączyć, i znowu przestawał odpowiadać.
- Poprawka wymagała pięciu kroków na każdym serwerze: wyłączenie z ruchu, restart z zawieszonego stanu, wgranie poprawki, drugi restart, powrót do pracy. Pomnożone przez tysiące serwerów na całym świecie.
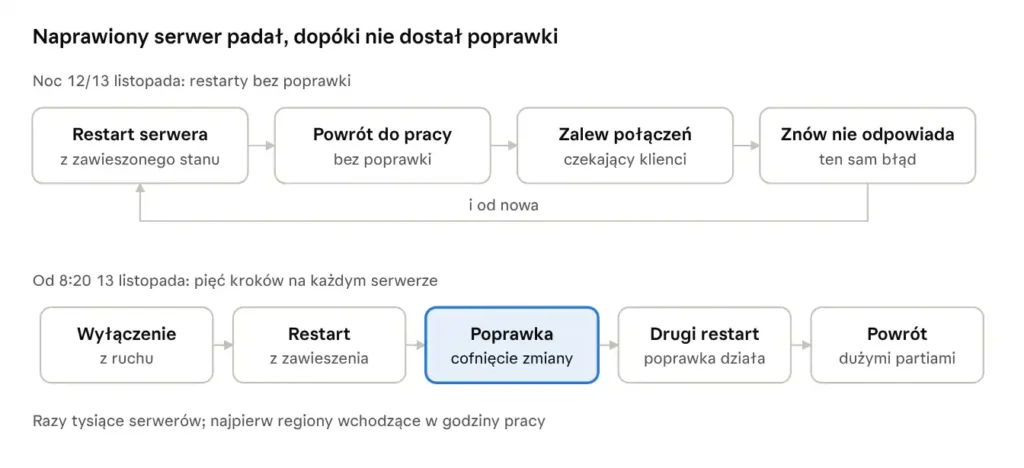
W nocy restart nie pomagał, bo serwer wracał z tym samym błędem prosto pod lawinę połączeń. Dopiero poprawka przerwała pętlę, ale kosztem pięciu kroków na każdym serwerze.
Przełom przyszedł 13 listopada o 8:20 czasu polskiego, gdy Microsoft zastosował na części serwerów poprawkę cofającą wadliwą zmianę. Potem przywracał serwery dużymi partiami, zaczynając od regionów wchodzących w godziny pracy. Europa wróciła do normy o 12:35, a aktywne skutki awarii skończyły się o 17:10.
Incydent zamknięto dopiero w sobotę o 5:15, po wydłużonym monitorowaniu i dostarczeniu zaległej poczty. Microsoft wydłużył czas ponawiania dostarczenia wiadomości z 24 do 48 godzin i według raportu żaden firmowy mail nie przepadł. Wyjątkiem była część wiadomości do kont prywatnych nieużywanych od ponad 30 dni, które wróciły do nadawców. Microsoft nie uznał awarii za zakończoną, gdy usługi wróciły, tylko gdy przetworzył to, co utknęło w kolejkach. To warto zapamiętać na później.
Polska przeszła to inaczej
W Polsce awaria trwała od czwartkowego wieczoru do piątkowego południa. Wieczór przeszedł prawie niezauważony, bo biura były już zamknięte. Zgłoszeń przybyło w piątek rano (GSMonline), a o 12:35 Europa według Microsoftu była już zdrowa. Pora dnia pomogła. Ale nie tylko ona.
Faktury nie przychodzą już pocztą. Od 1 lutego 2026 roku wszyscy podatnicy odbierają faktury przez Krajowy System e-Faktur. W kraju, w którym jeszcze niedawno faktury powszechnie wysyłano mailem jako PDF, awaria poczty nie zatrzymała obiegu najważniejszego dokumentu w firmie. Państwo, wprowadzając KSeF z zupełnie innych powodów, przy okazji wyprowadziło fakturę z poczty. Mailem nadal przychodzi sporo: faktury od zagranicznych dostawców, zamówienia, potwierdzenia, dokumenty magazynowe, ustalenia przy korektach. Ale nie to, bez czego księgowość staje.
Administracja ma własny obieg dokumentów. Wiceminister cyfryzacji Dariusz Standerski powiedział PAP, że urzędy działały bez zakłóceń dzięki własnemu systemowi elektronicznego zarządzania dokumentacją EZD (wnp.pl). EZD jest dla urzędu tym, czym KSeF dla firmy: dokumenty krążą poza pocztą, na osobnej infrastrukturze.
Banki i ZUS zgłosiły tylko utrudnienia w kontakcie mailowym z klientami. Platformy ZUS działały, a rzecznik ING mówił, że awaria co do zasady nie wpływa na operacje bankowe (Polskie Radio 24).
Firmy z pocztą u innego dostawcy prawie nic nie odczuły. Firmy, którymi się opiekuję, używają z Microsoft 365 OneDrive, Teams, kalendarzy i SharePointa, ale pocztę mają u innego dostawcy. Cała dobowa globalna awaria sprowadziła się u nich do kilku zgłoszeń, że nie działa wyszukiwarka plików. Raport Microsoftu to potwierdza: wyszukiwanie w OneDrive i SharePoincie korzysta z danych Exchange, więc padło razem z pocztą. Same pliki były na miejscu. Nikt nie zgłosił problemu z kalendarzem, choć Microsoft wymienia kalendarz w Teams wśród dotkniętych funkcji.
Piwnica i chmura są tak samo zawodne
Po każdej takiej awarii wraca to samo pytanie: czy nie lepiej było zostać przy własnym serwerze? Odpowiedź brzmi: serwer w piwnicy jest takim samym punktem awarii jak chmura. Psuje się z innych powodów i nie trafia na pierwsze strony gazet, ale dla jednej firmy jego awaria jest równie dotkliwa. Nie ma za sobą tysięcy inżynierów, a jego zapasowy dysk zwykle stoi w tej samej szafie.
Pytanie jest inne: czy rzeczy padają osobno. Firma, która ma ERP na własnym serwerze, pocztę u jednego dostawcy, pliki u drugiego, a faktury w KSeF, ma cztery punkty awarii. Żaden z nich nie zatrzymuje wszystkiego naraz. Gdyby ten sam serwer ERP stał na chmurowym Windowsie u tego samego dostawcy co poczta, efekt byłby jak przy poczcie. Ten mechanizm było zresztą widać: wśród dotkniętych usług Microsoft wymienił Windows 365, czyli komputery w chmurze, choć tylko przy jednej konkretnej konfiguracji.
To nie znaczy, że chmura jest zła. To znaczy, że złożoności nie należy z góry traktować jak problemu. Trzeba tylko odróżnić dwa jej rodzaje.
- Złożoność niezależna. Wiele systemów, z których każdy psuje się z innego powodu. Awarie się nie sumują. Wygląda to jak bałagan: kilka paneli, kilka umów, kilku dostawców. Działa jak ubezpieczenie.
- Złożoność spleciona. Wiele systemów, które od siebie zależą. ERP czyta faktury ze skrzynki, kalendarz mieszka w skrzynce, filtr bezpieczeństwa stoi między mailem a linkiem, komunikator przechodzi przez bramę poczty. Tu każdy dodatkowy element to kolejna droga, którą awaria przechodzi dalej. Tak było w brytyjskich szpitalach.
Problemem nie jest liczba systemów, tylko liczba rzeczy, które od siebie zależą. „Wszystko na jednej platformie” zmniejsza liczbę systemów, ale wiąże je ze sobą. Portal ITHardware zauważył to celnie: plan awaryjny polegający na tym, żeby o awarii poczty powiadomić pracowników przez Teams, nie jest wiele wart, gdy obie usługi kupuje się w jednym pakiecie (ITHardware).
Zapas też może być pozorny. Niedawno u dostawcy poczty jednej z obsługiwanych przeze mnie firm jednocześnie przestały działać podstawowy i zapasowy serwer DNS. Formalnie były dwa. W praktyce padły z tego samego powodu, więc zapas nie był zapasem. To ten sam błąd co przełączenie Teams na bramę poczty, tylko w małej skali. Zapas daje coś tylko wtedy, gdy psuje się z innego powodu niż podstawa.
Ostatnim zapasem są najprostsze kanały. Gdy KSeF nie działa, zostaje telefon do kontrahenta i mail. Gdy brytyjskiej służbie zdrowia stanęła poczta, został papier. Telefon i papier działają nie dlatego, że są lepsze, tylko dlatego, że nie dzielą infrastruktury z niczym innym. Ważniejsze od tego, czy istnieją, jest to, czy ludzie wiedzą, kiedy po nie sięgnąć.
Uzależnienie, suwerenność i to, co działa niezależnie od nich
Awaria szybko trafiła do debaty publicznej. Wicepremier i minister cyfryzacji Krzysztof Gawkowski napisał 13 listopada rano na X, że to „wyraźna ilustracja problemów z cyfrowym uzależnieniem od globalnych korporacji” (PAP). Ministerstwo zapowiedziało konkurs na pilotażowe wdrożenia otwartego oprogramowania w samorządach, z 10 mln zł z funduszy europejskich (PAP Samorząd). Prace nad nim zaczęły się jeszcze przed awarią (Kresy.pl). Wiceminister Standerski mówił PAP, że firmy i urzędy nie powinny polegać na usługach jednego dostawcy (wnp.pl).
Druga strona też ma argumenty. Microsoft Polska odpowiada, że jest platformą, a nie zamkniętym ekosystemem, a dane europejskich klientów są przetwarzane i przechowywane w Unii (Rzeczpospolita). Ta sama gazeta przypomina, dlaczego odejście od jednego dostawcy jest trudne: firma zależy od jego licencji, chmury, kont użytkowników, danych i integracji, więc zmiana jest kosztowna i ryzykowna. Dania próbowała przejść na otwarty pakiet biurowy i projekt porzuciła. Z drugiej strony raport Fundacji Instrat, na który powołuje się Rzeczpospolita, wskazuje, że 99% polskich przetargów na oprogramowanie biurowe eliminuje konkurencję albo faworyzuje Microsoft.
Ten tekst nie rozstrzyga, kto powinien dostarczać państwu i firmom usługi: globalna korporacja czy krajowy dostawca, oprogramowanie zamknięte czy otwarte. Pokazuje coś innego, co działa niezależnie od odpowiedzi na to pytanie. Otwarte oprogramowanie samo niczego nie rozdziela. Urząd, który postawi pocztę, pliki i komunikator na jednym własnym serwerze, będzie miał ten sam pojedynczy punkt awarii, tylko u siebie. I odwrotnie: firma u globalnego dostawcy, która trzyma pocztę osobno, a faktury w KSeF, przetrwa jego najgorszy dzień z kilkoma zgłoszeniami o wyszukiwarkę.
Wielkość dostawcy decyduje o tym, ilu ludzi naraz dotknie awaria. O tym, ile stanie w jednej organizacji, decyduje jej własna architektura.
Microsoft dochodzi do tego samego wniosku
Równie pouczające jest to, jak Microsoft naprawiał awarię i co zamierza zmienić. Pierwszym krokiem nie była poprawka, bo jej jeszcze nie było. Było nim rozdzielenie: Teams, OneDrive, SharePoint i aplikacje Office przeniesiono z powrotem na drugą bramę. Te usługi wróciły do działania wcześniej niż poczta.
Plan na przyszłość czyta się jak opis tezy z poprzednich rozdziałów, tylko w skali globalnej:
- podział przepustowości bram na osobne pule dla różnych usług, żeby awarie się nie przenosiły (pierwszy kwartał 2027),
- mniejsze strefy awarii, bo obecne regiony są za duże (bez terminu),
- przełączanie Teams tylko w regionie, którego dotyczy problem, a nie na całym świecie (do końca 2026),
- rozkład ruchu, który nie przenosi awarii do innych regionów (do końca 2026),
- stopniowe dopuszczanie ruchu do serwerów wracających do pracy, żeby od razu ich nie zalewał (bez terminu),
- testy obciążeniowe na najnowszym sprzęcie i z ruchem przypominającym prawdziwy (pierwszy kwartał 2027).
Do czasu wprowadzenia tych zmian Microsoft włączył tymczasowe zabezpieczenia, które blokują automatyczne rozkładanie ruchu, żeby awaria nie mogła rozlać się tak jak 12 listopada. Mechanizm, który miał chronić usługę, został na razie przyhamowany.
Po największej awarii roku dostawca usług dla ponad 430 milionów użytkowników wyciąga ten sam wniosek, do którego mała firma doszła, trzymając pocztę u innego dostawcy: nie wszystko w jednej puli.
Co z tego wynika dla firmy z ERP
Firma z systemem ERP nie zmieni architektury Microsoftu. Może za to sprawdzić własną. Wystarczą cztery pytania.
- Co padnie razem? Wypisz, z czego korzysta obieg dokumentów: gdzie przychodzą faktury, zamówienia i potwierdzenia, gdzie leżą pliki, przez co ludzie się umawiają, skąd ERP pobiera dane. Potem zaznacz, które z tych rzeczy stoją u tego samego dostawcy albo na tym samym serwerze. To one padną razem. Raport Microsoftu wprost wymienia aplikacje biznesowe i integracje łączące się z Exchange Online wśród tego, co nie działało. Jeśli ERP czyta dokumenty ze skrzynki, stał razem z pocztą.
- Jaka jest ścieżka ręczna? Na wypadek awarii każdego kanału powinno być wiadomo, kto do kogo dzwoni i gdzie zapisuje to, co trzeba później wprowadzić. Najlepiej, jeśli ta ścieżka nie jest teorią, tylko była kiedyś używana. Firma, która przy wdrażaniu automatyzacji przez kilka miesięcy prowadziła stary i nowy obieg równolegle, ma ją sprawdzoną w praktyce.
- Kiedy awaria naprawdę się skończy? Nie wtedy, gdy usługa wraca, tylko gdy wszystko, co utknęło w kolejce, trafi na miejsce. Po awarii kanału wejścia trzeba sprawdzić, czy dokumenty z czasu awarii weszły do obiegu i czy po automatycznych ponowieniach nic nie weszło dwa razy. Microsoft zamknął incydent dopiero po dostarczeniu zaległej poczty. Firma powinna stosować tę samą miarę.
- Ile kosztuje rozdzielenie? Uczciwie: więcej paneli administracyjnych, więcej umów, więcej integracji do utrzymania, więcej miejsc do zabezpieczenia. Rozdzielenie opłaca się tam, gdzie przestój kanału kosztuje więcej niż utrzymanie drugiego. Poczta firmy, która wysyła zamówienia do dostawców, zwykle spełnia ten warunek. Firmowy czat zwykle nie.
Jest też jedna rzecz na teraz: po tej awarii krążyły wiadomości phishingowe powołujące się na prawdziwy numer incydentu EX1550543 (WindowsForum). Stan usług Microsoftu sprawdza się tylko w centrum administracyjnym, nigdy z linku w mailu.
Zabawne było tylko tam, gdzie był zapas
W piątek polska telewizja pokazywała pracowników, którzy żartowali, że dzięki Microsoftowi mają wolne. W tym samym czasie w Wielkiej Brytanii pacjenci czekali na recepty, a szpitale przekładały operacje. To nie były dwie różne awarie i nie dwa różne poziomy zaufania do chmury. To były dwie różne mapy zależności.
Duzi dostawcy stali się częścią infrastruktury, od której zależą państwa, i nic nie wskazuje, żeby to się miało szybko zmienić. Tym bardziej warto wiedzieć, co w naszej własnej organizacji padnie razem, kiedy padnie jedno. Bałagan kilku dostawców, kilku kanałów i telefonu jako ostatniego zapasu nie wygląda elegancko. Ale 13 listopada działał.
Źródła
- Microsoft, Post-Incident Report EX1550543/MO1550821, raport końcowy z 20 listopada 2026 (centrum administracyjne Microsoft 365, dostępny dla administratorów)
- GSMonline: Globalna awaria Microsoft 365 zakłóciła działanie Outlooka i Teams
- Polsat News: Globalna awaria Microsoftu. Nowy komunikat firmy
- CNN: Microsoft outage live updates
- Wikipedia: 2026 Microsoft outage
- Nursing in Practice: Microsoft outage disrupts patient prescriptions and GP practice systems
- Times & Star: Microsoft outage disrupts crime reports and NHS services
- Bankier: Cyfrowy paraliż w biurach
- Forbes: Microsoft 365 Outage Improves Into Friday
- wnp.pl: Wielka awaria Microsoftu nie uderzyła w polskie urzędy
- Polskie Radio 24: Awaria Microsoftu kontra polskie banki i urzędy
- PAP: Minister cyfryzacji o ryzyku cyfrowego uzależnienia
- PAP Samorząd: Samorządy dostaną miliony na open source
- Kresy.pl: Gawkowski zapowiada rozwój open source
- Rzeczpospolita: Będzie odwrót od Microsoftu?
- ITHardware: Microsoft przeprosił za awarię
- WindowsForum: Phishing z prawdziwym numerem incydentu