
Modele hybrydowe: myślenie staje się ustawieniem
W 2024 roku model rozumujący był osobnym modelem. W 2025 stał się trybem w jednym modelu, potem decyzją automatycznego przełącznika, a w 2026 suwakiem w rękach użytkownika. Wybór modelu to dziś tylko połowa decyzji.
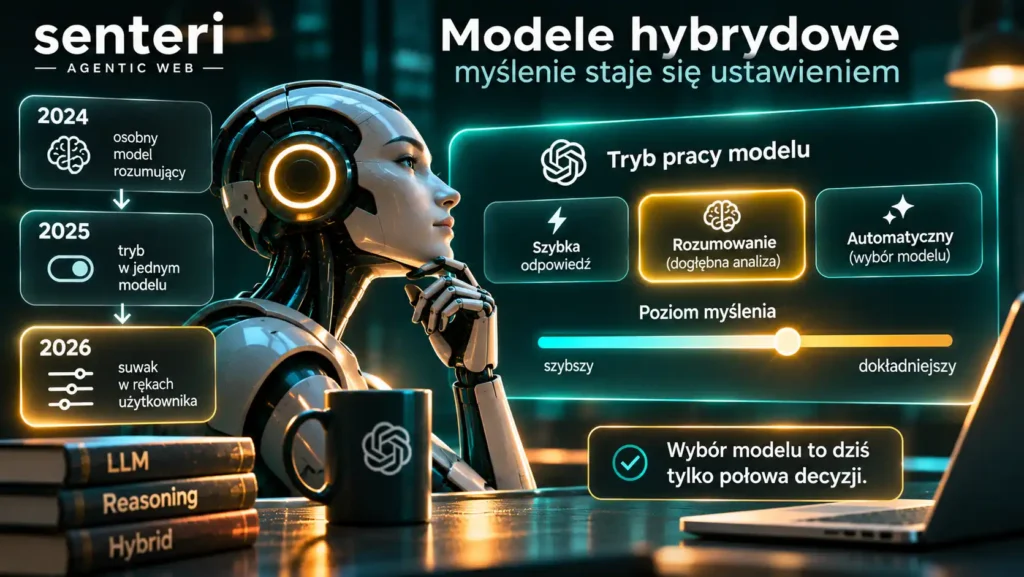
7 sierpnia 2025 OpenAI zrobiło coś, czego użytkownicy ChatGPT nie widzieli od lat: zabrało im listę modeli. Zamiast wybierać między GPT-4o, o3, o4-mini i kilkoma innymi, mieli po prostu rozmawiać z GPT-5. Pod spodem automatyczny przełącznik miał sam decydować, kiedy odpowiedzieć szybko, a kiedy pomyśleć dłużej.
Pierwszego dnia przełącznik przez część dnia nie działał. Sam Altman przyznał, że przez to GPT-5 wydawał się „dużo głupszy”, niż był. Ludzie, którzy rano dostali odpowiedź z szybkiego modelu, a wieczorem z myślącego, rozmawiali z dwoma różnymi systemami pod jedną nazwą.
To przejście jest o tym, jak „myślenie” z części siódmej przestało być osobnym modelem. Najpierw stało się trybem w jednym modelu, potem decyzją przełącznika, a na końcu suwakiem w rękach użytkownika. I o tym, że nie wszyscy uznali to za postęp.
Kiedy
- 24 lutego 2025: Claude 3.7 Sonnet, według Anthropic jeden model do szybkich odpowiedzi i do dłuższego rozumowania. Programista ustawia budżet na myślenie, a użytkownik widzi tok rozumowania. Tego samego dnia rusza Claude Code, agent do programowania w terminalu.
- 17 kwietnia 2025: Gemini 2.5 Flash, „pierwszy w pełni hybrydowy model rozumujący” Google. Budżet na myślenie od 0 do 24 576 tokenów, przy zerze model odpowiada od razu.
- Kwiecień 2025: Qwen3 z przełącznikiem między trybem myślenia i odpowiedzi bez myślenia.
- Lipiec 2025: zespół Qwen ogłasza, że rezygnuje z trybu hybrydowego i wraca do osobnych modeli Instruct i Thinking.
- 7 sierpnia 2025: GPT-5 w ChatGPT z automatycznym przełącznikiem. W API nowe ustawienia: wysiłek rozumowania od „minimal” w górę i osobny parametr długości odpowiedzi.
- 21 sierpnia 2025: DeepSeek V3.1 łączy tryb myślenia i tryb bez myślenia w jednym modelu. R1 jako osobna linia przestaje być potrzebny.
- Sierpień–wrzesień 2026: GPT-5.6 Sol w ChatGPT jako jeden model z suwakiem wysiłku rozumowania. Od 14 września ChatGPT przestaje sam przełączać płacących użytkowników z trybu szybkiego w tryb myślenia.
Co odziedziczył
Rozumowanie wytrenowane przez nagradzanie poprawnych wyników, z o1 i R1. Modele hybrydowe nie wymyśliły myślenia na nowo, tylko nauczyły jeden model obu zachowań: odpowiedzieć od razu albo najpierw napisać sobie długi brudnopis.
Odziedziczył też problem kosztu z części siódmej: tokeny rozumowania kosztują, a ich liczba zależy od pytania. Różnica polegała na tym, kto o niej decyduje.
Co dostał nowego
Jedne wagi, dwa zachowania. Zamiast utrzymywać osobny model szybki i osobny rozumujący, producent trenuje jeden, który umie pracować w obu trybach. Anthropic przy Claude 3.7 Sonnet ujęło to tak, że rozumowanie powinno być jedną z umiejętności modelu, a nie osobnym modelem. Dla tego, kto płaci za API, to prostsza oferta: jeden model, jedno zachowanie do przetestowania, a głębokość myślenia ustawiana w zapytaniu.
Budżet zamiast wyboru modelu. Gemini 2.5 Flash pozwalał ustawić budżet na myślenie od zera w górę. GPT-5 w API dostał wysiłek rozumowania z poziomem „minimal”, który OpenAI zalecało do prostych zadań: wyciągania danych, formatowania, prostej klasyfikacji, a odradzało przy planowaniu wielu kroków i pracy z narzędziami. Do tego osobny parametr długości odpowiedzi, żeby nie trzeba było przerabiać promptu, gdy odpowiedź ma być krótsza.
Przełącznik, który decyduje za ciebie. W ChatGPT GPT-5 miał sam ocenić, czy pytanie wymaga namysłu. Idea była prosta: użytkownik nie powinien musieć wiedzieć, że istnieją modele szybkie i rozumujące. To ta sama logika, która przez lata rządziła produktami: ukryć technikę i dać jeden przycisk.
Od 2025 roku pytanie „który model?” coraz częściej zamienia się w pytanie „ile ma myśleć?”. A odpowiedź na nie to decyzja o czasie i koszcie, a nie o jakości modelu.
Czego to nie rozwiązało
Przejrzystości przełącznika. Kiedy przełącznik decyduje, użytkownik nie wie, który model mu odpowiedział ani jak długo myślał. Awaria w dniu premiery pokazała to najlepiej: ta sama nazwa, inna jakość, w zależności od tego, czy przełącznik akurat działał. To kolejna odsłona problemu z części pierwszej: nazwa produktu to nie nazwa modelu. A „GPT-5 powiedział” znaczyło już nie jeden model, tylko jeden z kilku wariantów wybrany przez algorytm.
Zaufania. Ludzie stracili możliwość wyboru modelu, do którego byli przyzwyczajeni. Jak opisała część szósta, protest był tak głośny, że OpenAI po kilku dniach przywróciło GPT-4o płacącym. W 2026 roku firma poszła dalej i oddała użytkownikom kontrolę: zamiast automatycznego przełączania suwak, który ustawia się samemu.
Ceny jakości. Hybryda nie jest darmowa. Zespół Qwen po trzech miesiącach z trybem hybrydowym napisał wprost, że lepsza jakość odpowiedzi jest ważniejsza niż jeden wspólny model, i wrócił do osobnych modeli. To ważny głos w tej genealogii: połączenie dwóch zachowań w jednych wagach może osłabić oba.
Wiarygodności prezentacji. Na pokazie GPT-5 wykresy z wynikami miały błędy, które Altman tłumaczył zmęczeniem zespołu, zapewniając, że wpis na blogu i karta systemowa są poprawne. Drobiazg, ale przypomnienie z części trzeciej: wynik w tabeli producenta to deklaracja, nie pomiar w twojej firmie.
Co to zmieniło dla stron i firm
Wysiłek rozumowania to parametr do ustawienia dla każdego zadania. W systemie, który wyciąga numer faktury z maila, klasyfikuje dokument albo formatuje dane, minimalny wysiłek daje tę samą jakość szybciej i taniej. W systemie, który planuje kilka kroków, wywołuje narzędzia i sprawdza wyniki, oszczędzanie na myśleniu się mści. Najlepiej ustawić wysiłek osobno dla każdego typu zadania, zamiast jednego dla całej aplikacji. Kiedy rozumowanie się opłaca, opisuje „Modele rozumujące”.
Do logów trafia nie tylko model, ale i ustawienie. Ten sam model z wysiłkiem „minimal” i „high” zachowuje się jak dwa różne systemy. Jeśli w logach jest tylko nazwa modelu, nie odróżnisz regresji od tego, że ktoś zmienił ustawienie. Do zasad z części pierwszej dochodzi więc trzecia: zapisuj model, migawkę i ustawienia rozumowania. Szerzej w „Co logować w pętli agenta”.
Rachunek zależy od decyzji, a nie tylko od pytania. Przy osobnych modelach koszt był zapisany w wyborze modelu. Przy modelach hybrydowych zapisany jest w parametrze, który łatwo zmienić jedną linijką i równie łatwo zapomnieć. Objaw, kiedy ktoś zmieni go po cichu, opisuje „Rachunek eksplodował, a nic się nie zmieniło”.
Agent, który pisze kod. Claude Code, wypuszczony razem z pierwszym dużym modelem hybrydowym, pokazał, do czego ta elastyczność służy: agent w długiej pracy potrzebuje szybkich odpowiedzi przy prostych krokach i namysłu przy trudnych. To kontynuacja modelu, który działa, z części dziewiątej, tyle że w terminalu zamiast na ekranie.
Jedna myśl na drogę
Między wrześniem 2024 a wrześniem 2026 „myślenie” przeszło drogę od osobnego modelu, przez automatyczny przełącznik, do suwaka. Wniosek dla firm: wybór modelu to dziś tylko połowa decyzji. Druga połowa to to, ile pozwolisz mu myśleć przy każdym zadaniu, i czy zapisujesz, ile myślał.
W ostatniej części serii: rok 2026, w którym głównym podziałem między modelami przestała być wielkość czy umiejętności, a stał się dostęp. Mythos i Fable, półki GPT-6, Muse bez otwartych wag.
Źródła
- Claude 3.7 Sonnet: model hybrydowy, budżet na myślenie, Claude Code (TechCrunch, 24 lutego 2025)
- Google, „Start building with Gemini 2.5 Flash” (17 kwietnia 2025)
- Alibaba rezygnuje z trybu hybrydowego w Qwen3 (The Register, 31 lipca 2025)
- Altman o nieudanej premierze GPT-5, przełączniku i powrocie GPT-4o (VentureBeat, 8 sierpnia 2025)
- OpenAI Cookbook, „GPT-5 New Params and Tools”: wysiłek „minimal” i parametr długości odpowiedzi (7 sierpnia 2025)
- DeepSeek V3.1: tryb myślenia i bez myślenia w jednym modelu (x-cmd, sierpień 2025)
- Modele GPT od GPT-1 do GPT-6.1: GPT-5.6 Sol z suwakiem, koniec automatycznego przełączania w ChatGPT (Toloka, październik 2026)