
To samo pytanie, dwie odpowiedzi
Ta sama faktura, to samo polecenie, ten sam model, temperatura ustawiona na zero. Rano jedna kategoria kosztu, po południu inna. To nie błąd i nie zmiana modelu. Odpowiedź modelu to próbka, a nie wynik obliczenia.
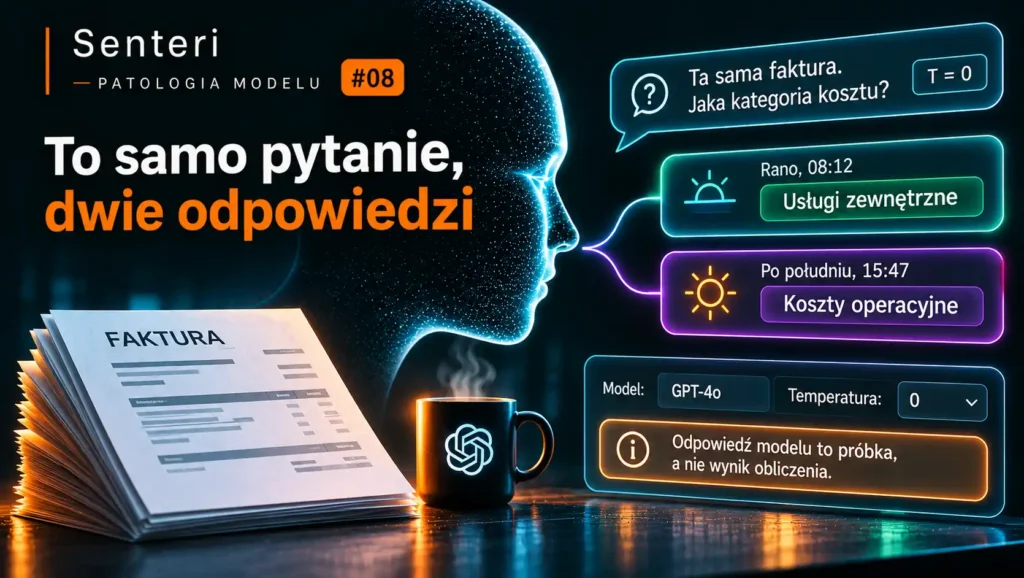
Dział księgowości używa modelu do wstępnej klasyfikacji faktur kosztowych. Polecenie jest stałe, model przypięty do konkretnej wersji, temperatura ustawiona na zero, „żeby było powtarzalnie”. Przy kontroli okazuje się, że ta sama faktura za usługę serwisową, wysłana dwa razy w odstępie kilku godzin, raz trafiła do kategorii „naprawy i konserwacja”, a raz do „usługi obce”. Obie odpowiedzi da się obronić, ale nie da się obronić tego, że są dwie.
W poprzedniej części zmieniał się model pod tą samą nazwą. Tu nic się nie zmieniło: ta sama wersja, ten sam serwer, te same ustawienia. Model po prostu odpowiada różnie na to samo pytanie. To najzwyklejsza z patologii modelu i ta, którą najczęściej się lekceważy, bo wydaje się, że temperatura zero ją wyłącza.
Objaw
To samo wejście daje różne wyjścia. Czasem różnica dotyczy tylko sformułowania, czasem samej odpowiedzi: innej kategorii, innej liczby, innego „tak” albo „nie”.
Przy zwykłych ustawieniach to zamierzone. Model wybiera kolejne słowo losowo, zgodnie z rozkładem prawdopodobieństwa, a temperatura mówi, jak bardzo ten rozkład spłaszczyć. Aplikacje czatu działają właśnie tak, żeby odpowiedzi były naturalne i różnorodne. Zaskoczenie zaczyna się przy temperaturze zero, która teoretycznie każe zawsze wybierać najbardziej prawdopodobne słowo.
W 2024 roku zespół z Comcast i Penn State sprawdził to wprost. Puścił kilka modeli na ośmiu zadaniach z popularnych testów, kilka razy z rzędu, z ustawieniami możliwie najbardziej deterministycznymi. Trafność tego samego modelu na tym samym zadaniu różniła się między przebiegami nawet o 10%. Żaden model nie dawał powtarzalnej trafności we wszystkich zadaniach. Surowy tekst odpowiedzi prawie nigdy nie był identyczny we wszystkich przebiegach. Same odpowiedzi, wyciągnięte z tekstu, były stabilniejsze, ale też rzadko w 100%.
We wrześniu 2025 laboratorium Thinking Machines, założone przez byłą dyrektorkę technologiczną OpenAI Mirę Murati, zrobiło eksperyment, który dobrze pokazuje skalę zjawiska. Wysłało to samo polecenie tysiąc razy do otwartego modelu Qwen3-235B, przy temperaturze zero. Dostało 80 różnych odpowiedzi. Najczęstsza pojawiła się 78 razy. Wszystkie były identyczne przez pierwsze 102 tokeny, a potem zaczęły się rozchodzić.
Odpowiedź modelu to nie wynik obliczenia. To próbka.
Skąd się bierze
Przy zwykłych ustawieniach: z losowania. To cecha, nie błąd. Bez niej model przy każdym pytaniu wybierałby tę samą, najbardziej przewidywalną drogę, a jego teksty byłyby sztywne i powtarzalne.
Przy temperaturze zero: z tego, z kim dzielisz serwer. Popularne wyjaśnienie mówiło o niedokładności obliczeń na liczbach zmiennoprzecinkowych i równoległości kart graficznych. Thinking Machines pokazało, że to tylko część prawdy. Pojedyncze operacje w modelu dają za każdym razem ten sam wynik. Problem w tym, że dostawca grupuje twoje zapytanie z zapytaniami innych użytkowników, żeby lepiej wykorzystać sprzęt. Liczba zapytań w grupie zależy od obciążenia serwera, a od niej zależy kolejność, w jakiej sumowane są liczby wewnątrz modelu. Inna kolejność daje minimalnie inne wyniki. Gdy dwa słowa mają prawie równe prawdopodobieństwo, ta minimalna różnica wystarcza, żeby wybrać inne. Od tego miejsca odpowiedź idzie inną drogą.
Twoja odpowiedź zależy więc od tego, ile osób w tej samej chwili pytało o coś innego. Z twojego punktu widzenia to czysty przypadek.
Da się to naprawić, ale to kosztuje. Thinking Machines przepisało kluczowe operacje tak, żeby wynik nie zależał od wielkości grupy. Wtedy wszystkie tysiąc odpowiedzi były identyczne. Ceną była szybkość: w ich teście na mniejszym modelu zadanie, które zwykle trwało 26 sekund, trwało 42. Dla dostawcy, który obsługuje miliony zapytań, to poważny koszt. Autorzy wcześniejszego badania z Comcast doszli do podobnego wniosku: niedeterminizm jest najpewniej ceną za wydajne wykorzystanie mocy obliczeniowej i nie zniknie szybko.
Producenci to przyznają. OpenAI oferuje parametr seed i opisuje wynik jako „w większości” powtarzalny, pod warunkiem że nie zmieni się konfiguracja serwerów, którą firma ujawnia w polu system_fingerprint. Google pisze, że przy temperaturze zero odpowiedzi są „w większości deterministyczne”, ale możliwa jest niewielka zmienność. Anthropic pisze, że nawet przy temperaturze zero wyniki nie są w pełni deterministyczne. Przy części najnowszych modeli temperatury nie da się już w ogóle ustawić. Przy przejściu na Claude Opus 5.5 taka próba zwraca błąd, o czym pisze dwunasta część Genealogii.
Z czym to pomylić
Ze zmianą modelu. Zmienność to rozrzut wokół tej samej średniej. Zmiana modelu, opisana w poprzedniej części, to przesunięcie samej średniej. Test: puść to samo pytanie kilkanaście razy i porównaj z tym, co wychodziło miesiąc temu. Jeśli rozrzut jest podobny, a średnia ta sama, to zwykła zmienność. Jeśli średnia się przesunęła, coś się zmieniło.
Ze zmyślaniem. Tu zmienność jest sygnałem. Jeśli na pytanie o fakt model za każdym razem podaje inną datę albo liczbę, to znak, że zgaduje. Ale działa to tylko w jedną stronę: zgodne odpowiedzi nie dowodzą prawdy, bo model potrafi powtarzać to samo zmyślenie.
Z objawem agenta. W agencie zmienność się kumuluje. Jedno inne słowo na początku prowadzi do innego wyboru narzędzia, inny wynik narzędzia do innego planu, i po dwudziestu krokach dwa przebiegi tego samego zadania wyglądają zupełnie inaczej. Do tego agent, który ponawia nieudane kroki, może wykonać to samo działanie dwa razy. Ten objaw opisuje „Agent zrobił to samo dwa razy”, a zmienność modelu jest jedną z jego przyczyn, piętro niżej.
Co da się zrobić po stronie pytania
- Zawęź odpowiedź. Im mniej możliwych odpowiedzi, tym mniej miejsca na rozrzut. Lista dozwolonych kategorii, wybór z kilku opcji, odpowiedź w ustalonym formacie zamiast wolnego tekstu. W badaniu z Comcast same odpowiedzi były wyraźnie stabilniejsze niż pełny tekst.
- Przy ważnych decyzjach pytaj kilka razy. Puść klasyfikację trzy albo pięć razy. Jeśli wszystkie odpowiedzi są zgodne, przyjmij. Jeśli nie, oddaj sprawę człowiekowi. Rozbieżność to darmowy sygnał, że przypadek jest niejednoznaczny.
- Zapisuj odpowiedź, nie odtwarzaj jej. Jeśli decyzja modelu ma znaczenie dla księgowości, audytu albo klienta, zapisz ją w chwili, gdy zapadła, razem z poleceniem i identyfikatorem modelu. Odtworzenie decyzji to odczyt z zapisu, a nie ponowne pytanie modelu.
- To, co musi być deterministyczne, licz w kodzie. Kwota VAT, suma pozycji, termin płatności z daty wystawienia. Model może odczytać dane z dokumentu, ale rachunek powinien zrobić zwykły program, który za każdym razem da ten sam wynik.
- Testuj kilka razy i podawaj rozrzut. Jeden przebieg testu to jedna próbka. Autorzy badania z Comcast zwracają uwagę, że różnica między dwoma modelami w rankingu może wynikać po prostu z przypadku. Własny zestaw kontrolny puszczaj co najmniej kilka razy i patrz na najgorszy wynik, nie tylko na średni.
- Jeśli potrzebujesz powtarzalności co do bitu, uruchom model u siebie. Z otwartym modelem na własnym serwerze możesz włączyć tryb deterministyczny, który pokazało Thinking Machines, za cenę szybkości. W chmurze dostawcy tej kontroli nie masz.
Czego nie da się zrobić
Wyłączyć tego temperaturą zero. Temperatura zero usuwa losowanie, ale nie usuwa wpływu obciążenia serwera. To ustawienie o najmniejszej zmienności, a nie ustawienie bez zmienności.
Dostać gwarancji od dostawcy. OpenAI, Google i Anthropic piszą w dokumentacji to samo innymi słowami: „w większości”, „niewielka zmienność”, „nie w pełni”. Żaden nie obiecuje identycznej odpowiedzi.
Odtworzyć odpowiedzi sprzed miesiąca. Nawet jeśli zapytasz identycznie, nie wiesz, czy trafisz na tę samą gałąź. Do tego model mógł się w międzyczasie zmienić. Jedyny sposób, żeby wiedzieć, co model wtedy odpowiedział, to zapis.
Uznać zgodność za poprawność. Pięć identycznych odpowiedzi oznacza, że model jest pewny swojego wyboru, a nie że wybór jest dobry. Głosowanie kilku odpowiedzi wyłapuje przypadki niejednoznaczne, ale nie wyłapuje błędu, który model popełnia konsekwentnie.
Jedna myśl na drogę
Program komputerowy przyzwyczaił nas, że to samo wejście daje to samo wyjście. Model językowy tę umowę zrywa, nawet gdy wszystkie ustawienia mówią coś innego. Nie trzeba z tym walczyć, wystarczy przestać to zakładać: tam, gdzie liczy się powtarzalność, decyzję modelu się zapisuje, a rachunek robi kod.
W następnej części: model myśli dłużej i wychodzi gorzej, czyli dlaczego wyższe ustawienie rozumowania nie zawsze daje lepszą odpowiedź, za to zawsze daje wyższy rachunek.
Źródła
- Horace He i Thinking Machines Lab, „Defeating Nondeterminism in LLM Inference” (10 września 2025)
- Atil i in., „LLM Stability: A detailed analysis with some surprises” / „Non-Determinism of »Deterministic« LLM Settings” (Penn State i Comcast AI Technologies, arXiv 2024–2025)
- OpenAI, parametr seed i system_fingerprint (listopad 2023)
- Zestawienie stanowisk OpenAI, Google i Anthropic w sprawie temperatury zero (Unstract)