
Ta sama nazwa, inny model
W sierpniu 2025 coraz więcej użytkowników Claude zgłaszało, że model odpowiada gorzej niż tydzień wcześniej. W sieci krążyła teoria, że Anthropic po cichu przykręca jakość, żeby oszczędzić moc obliczeniową. Według Anthropic zgłoszenia początkowo trudno było odróżnić od zwykłych wahań w opiniach użytkowników.
9 września Anthropic potwierdziło na stronie statusu dwa błędy, a 17 września opublikowało raport z trzech błędów w infrastrukturze, które od początku sierpnia nakładały się na siebie i pogarszały odpowiedzi. Najpoważniejszy kierował część zapytań do Claude Sonnet 4 na serwery przygotowane pod nową, dłuższą wersję okna kontekstu. Na początku dotyczył 0,8% zapytań do Sonnet 4. Po rutynowej zmianie w rozkładaniu ruchu w najgorszej godzinie, 31 sierpnia, dotyczył już 16% zapytań do tego modelu. Około 30% użytkowników Claude Code, którzy pracowali w tym czasie, miało co najmniej jedną wiadomość obsłużoną przez niewłaściwy serwer. Drugi błąd sprawiał, że w angielskich odpowiedziach Opus 4.1, Opus 4 i Sonnet 4 pojawiały się przypadkowe znaki tajskie albo chińskie. Trzeci wynikał z błędu w kompilatorze: przy wybieraniu kolejnego słowa czasem odpadał z puli kandydatów ten najbardziej prawdopodobny. Potwierdzono go w Haiku 3.5. Naprawy trwały do 18 września.
Anthropic zapewnia w raporcie, że nigdy nie obniża jakości modelu z powodu popytu, pory dnia ani obciążenia serwerów, a zgłaszane problemy wynikały wyłącznie z tych błędów. To deklaracja firmy, której nikt z zewnątrz nie może sprawdzić. Znalezione błędy ją uprawdopodabniają, ale jej nie dowodzą. Firma przyznała też, że za bardzo ufała swoim testom i nie powiązała wzrostu zgłoszeń z końca sierpnia ze zmianą, którą sama wprowadziła.
Przez cały ten czas nazwa modelu się nie zmieniła. Użytkownik, który wybrał Claude Sonnet 4, dostawał Claude Sonnet 4. Tyle że czasem działał on na serwerze, który robił z jego odpowiedziami coś innego, niż powinien.
Jak czytać nazwy modeli, co to są migawki i aliasy i dlaczego w produkcji wskazuje się konkretną datę, opisuje pierwsza część Genealogii. Ta część jest o objawie: jak go rozpoznać i co z nim zrobić, gdy migawka nie wystarcza.
Objaw
To samo polecenie, ta sama nazwa modelu, a wyniki wyraźnie inne niż wcześniej albo niż u kogoś innego. Za tym objawem stoją cztery różne mechanizmy.
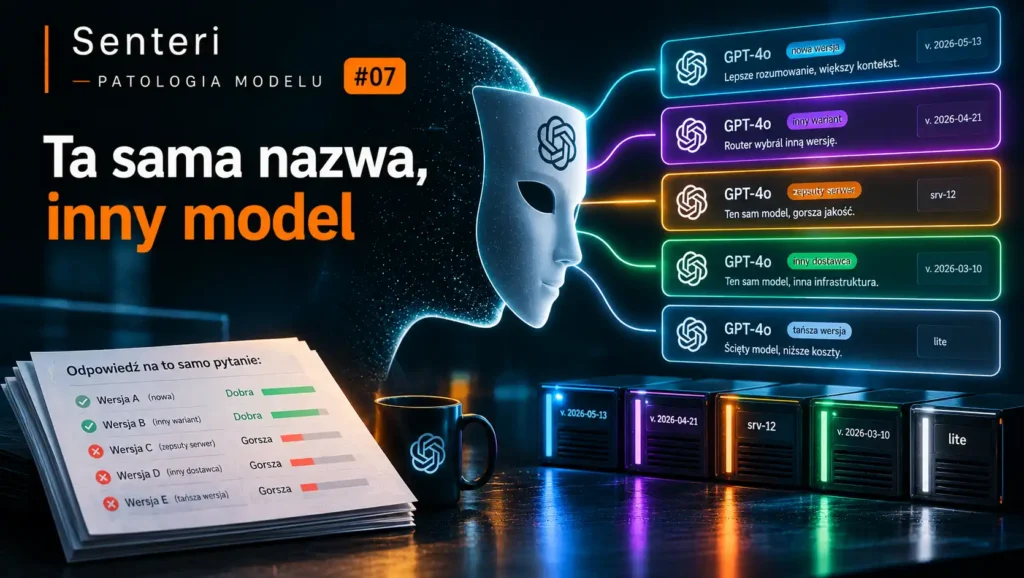
Nazwa wskazuje nową wersję. W 2023 roku badacze ze Stanfordu i Berkeley porównali dwie wersje GPT-4 z API: z marca i z czerwca. Ogólna nazwa „gpt-4” przeszła w tym czasie z jednej na drugą. Przy rozpoznawaniu liczb pierwszych trafność spadła z 84% do 51%, a jednocześnie GPT-3.5 na tym samym zadaniu poprawił się z 49,6% do 76,2%. Czerwcowy GPT-4 gorzej wykonywał polecenia, a obie czerwcowe wersje częściej myliły się w formatowaniu kodu. Wynik z liczbami pierwszymi był potem krytykowany: inni badacze wskazali, że marcowy model prawie zawsze odpowiadał „pierwsza”, a czerwcowy „złożona”, więc zmieniło się zachowanie, niekoniecznie umiejętność. Dla użytkownika to zresztą żadna pociecha. Autorzy podsumowali, że zachowanie tej samej usługi może się wyraźnie zmienić w krótkim czasie, i zalecili stałe monitorowanie jakości. Ten sam mechanizm, tylko w aplikacji, a nie w API, opisuje szósta część Genealogii przy aktualizacji GPT-4o z kwietnia 2025.
Router wybiera inny wariant. Pod jedną nazwą coraz częściej pracuje kilka modeli, a o tym, który odpowie, decyduje osobny mechanizm. Przy premierze GPT-5 w sierpniu 2025 przełącznik, który miał kierować pytania do odpowiedniej wersji modelu, przez część dnia nie działał. Sam Altman napisał, że przez to GPT-5 „wydawał się dużo głupszy”. W 2026 roku ten sam mechanizm działa świadomie przy Fable: pytania uznane za ryzykowne trafiają do słabszych modeli, o czym pisze trzynasta część Genealogii.
Ten sam model działa na innym serwerze. Przypadek z otwarcia. Model to nie tylko wagi, ale też oprogramowanie, które je uruchamia: ustawienia próbkowania, kompilator, pamięć podręczna, rozkład ruchu. Błąd w którymkolwiek z tych miejsc może zmienić odpowiedzi równie mocno jak nowa wersja modelu, tylko nikt tego nie ogłasza. Ciekawy szczegół: drugi i trzeci błąd z sierpnia nie dotyczyły chmur Amazona i Google, a pierwszy był tam marginalny. Gorzej działało API samego producenta niż u pośredników.
Ten sam model u innego dostawcy. Modele z otwartymi wagami udostępnia wiele firm naraz, pod tą samą nazwą. Moonshot AI, twórca modeli Kimi, po premierze K2 Thinking dostawał zgłoszenia, że wyniki testów nie zgadzają się z tymi, które firma opublikowała. Sprawdziło dostawców i ustaliło, że różnice są powszechne, a znaczna część wynikała z niewłaściwych ustawień generowania odpowiedzi. Dochodzą do tego kwantyzacja, czyli zapis wag z mniejszą precyzją, żeby model był tańszy i szybszy, oraz błędy, które wychodzą dopiero przy długich odpowiedziach. Firma udostępniła narzędzie, którym każdy może sprawdzić, czy dostawca uruchamia model tak, jak powinien.
Nazwa modelu to umowa o tym, czego się spodziewać. Nie jest gwarancją, że dostaniesz to samo co wczoraj.
Skąd się bierze
Z tego, że model jest usługą, a nie plikiem. Gdy wołasz model przez API albo rozmawiasz z nim w aplikacji, korzystasz z całego łańcucha: wag, oprogramowania, które je uruchamia, serwerów, rozkładania ruchu, a coraz częściej także routera i zabezpieczeń. Każde ogniwo może się zmienić niezależnie od nazwy. Anthropic opisało w raporcie, że obsługuje Claude na trzech rodzajach sprzętu, z których każdy wymaga osobnych optymalizacji, a utrzymanie identycznych wyników na wszystkich jest osobnym zadaniem.
Z tego, że producent ciągle coś poprawia. Aktualizacje modeli w aplikacjach, nowe migawki w API, zmiany w routerze i w zabezpieczeniach wychodzą często. Każda zmiana, która poprawia jedną rzecz, może pogorszyć inną. Badanie GPT-4 z 2023 roku pokazało to w jednym porównaniu: ten sam okres, dwa modele, jeden lepszy, drugi gorszy.
Z tego, że testy nie widzą wszystkiego. Anthropic przyznało w raporcie, że jego testy nie wychwyciły pogorszenia, o którym pisali użytkownicy. Część błędów pojawiała się tylko na niektórych platformach i tylko w niektórych zapytaniach, a przekierowanie było „lepkie”: kto raz trafił na zły serwer, często trafiał tam dalej. Dla jednych model był zepsuty, dla innych działał normalnie.
Z czym to pomylić
Ze zwykłą zmiennością. Model odpowiada na to samo pytanie trochę inaczej za każdym razem. Jedna gorsza odpowiedź niczego nie dowodzi. Na tę samą trudność powoływało się Anthropic. Zmiana modelu to przesunięcie całego rozkładu: wiele odpowiedzi na te same pytania jest gorszych niż wcześniej. Zwykłej zmienności poświęcona jest następna część.
Z własną zmianą. Zanim uznasz, że zmienił się model, sprawdź, czy nie zmieniło się nic po twojej stronie: polecenie systemowe, dane, kolejność dokumentów, wersja biblioteki, ustawienia. Bez zapisu identyfikatora modelu przy każdym wywołaniu tego nie rozstrzygniesz, o czym pisze pierwsza część Genealogii.
Z wersją pod ranking. W poprzedniej części Llama 4 Maverick startowała w rankingu w innej wersji niż ta udostępniona publicznie. To ten sam objaw, tylko zamiast różnicy między wczoraj a dziś jest różnica między rankingiem a twoim API.
Z objawem agenta. Agent, który działał wczoraj, a dziś nie, może mieć też inne przyczyny: zmienione API narzędzia, inny format danych, wygasłe uprawnienia. Ten objaw opisuje „Działał wczoraj, dziś nie działa”. Zmiana modelu pod tą samą nazwą to jedna z jego przyczyn, piętro niżej.
Co da się zrobić po stronie pytania
- Wskaż migawkę i zapisuj, co odpowiedziało. To podstawa opisana w Genealogii. Zapisuj też identyfikator modelu, który zwraca odpowiedź API, a nie tylko ten, o który prosiłeś. Przy routerach i przekierowaniach to nie musi być to samo.
- Miej zestaw kontrolny i puszczaj go regularnie. Kilkadziesiąt stałych pytań z twojej pracy, z oceną, którą da się policzyć. Puszczaj je codziennie albo co tydzień i patrz na wynik w czasie. Jedna gorsza odpowiedź nic nie znaczy. Spadek średniej z kilkudziesięciu pytań już tak.
- Do ważnej pracy używaj API, nie aplikacji. W aplikacji czatu nie wybierzesz migawki, nie wyłączysz routera i nie zobaczysz, który model odpowiedział. W API przynajmniej część z tych rzeczy kontrolujesz.
- Przy otwartych modelach wybieraj dostawcę świadomie. Sprawdź, czy podaje stopień ścieśnienia wag i ustawienia generowania. Puść swój zestaw kontrolny u dwóch–trzech dostawców, zanim wybierzesz. Jeśli twórca modelu udostępnia narzędzie do weryfikacji, jak Moonshot przy Kimi, użyj go. Niższa cena może wynikać z kwantyzacji albo innych ustawień, więc sprawdź, zanim założysz, że to ten sam model.
- Gdy coś zauważysz, zapisz i zgłoś. Data, godzina, polecenie, odpowiedź, identyfikator modelu. Anthropic napisało, że pomogły mu zgłoszenia użytkowników, i zapowiedziało lepsze narzędzia do ich przeglądania. Według raportu zasady prywatności ograniczają inżynierom wgląd w rozmowy, chyba że użytkownik sam prześle je w zgłoszeniu. Bez konkretnego przykładu zgłoszenie „model zgłupiał” trudno odróżnić od zwykłej zmienności.
Czego nie da się zrobić
Zabezpieczyć się samą migawką. Migawka chroni przed nowymi wagami. Nie chroni przed błędem w serwerze, kompilatorze czy rozkładaniu ruchu. W sierpniu 2025 błędy dotyczyły modeli o stałych, datowanych identyfikatorach, więc przypięcie migawki nie chroniło.
Zamrozić modelu na zawsze. Każda migawka kiedyś zostaje wycofana. Pierwsza migawka GPT-4o przestała działać w październiku 2026, a Fable 5.1 trafił na listę starszych modeli po niecałych dziesięciu tygodniach. Zmiana modelu jest pewna. Wycofania migawek w API są zapowiadane, ale w aplikacjach i przy błędach niepewne jest, kiedy i czy ktoś cię uprzedzi.
Liczyć, że dostawca powie od razu. Przy GPT-5 prezes OpenAI przyznał się do awarii routera następnego dnia, ale była to jedna, głośna awaria w dniu premiery. Przy Claude błędy były przerywane i trudniejsze do zdiagnozowania. Pierwsze potwierdzenie pojawiło się na stronie statusu ponad pięć tygodni po starcie pierwszego błędu, a pełny raport 17 września, już po naprawach. Krytycy wytykali, że przez ten czas użytkownicy nie wiedzieli, czy problem jest po ich stronie. W obu przypadkach o problemie najpierw wiedzieli użytkownicy, a nie oficjalne komunikaty.
Wykryć tego z jednej odpowiedzi. Pojedyncza słaba odpowiedź wygląda tak samo, czy model się zmienił, czy po prostu trafiłeś na gorszy los. Rozstrzyga tylko porównanie wielu odpowiedzi w czasie.
Jedna myśl na drogę
Przyzwyczailiśmy się myśleć o modelu jak o programie, który ma wersję i robi to samo, dopóki go nie zaktualizujesz. Model w chmurze bardziej przypomina dostawcę prądu: nazwa taryfy się nie zmienia, ale napięcie w gniazdku zależy od rzeczy, których nie widzisz. Z tą różnicą, że dla prądu są normy i niezależne pomiary, a dla modeli jeszcze nie. Dlatego licznik musi być po twojej stronie.
W następnej części: to samo pytanie, dwie odpowiedzi, czyli dlaczego model odpowiada inaczej, nawet gdy nic się nie zmieniło.
Źródła
- Anthropic, „A postmortem of three recent issues” (17 września 2025) oraz omówienie w InfoQ (październik 2025)
- Chen, Zaharia, Zou, „How is ChatGPT's behavior changing over time?” (Stanford i UC Berkeley, arXiv 2023; Harvard Data Science Review 2024)
- Strona statusu Claude: potwierdzenie błędów (9 września 2025)
- Awaria przełącznika przy premierze GPT-5 (Axios, 12 sierpnia 2025)
- Moonshot AI, „Rebuilding the Chain of Trust: Kimi Vendor Verifier” (kwiecień 2026)
Tekst powstał we współpracy z Claude, modelem Anthropic. Głównym przykładem w tekście są błędy w obsłudze modeli Claude, opisane w raporcie samego Anthropic. Dlatego przed publikacją tekst przeszedł niezależną kontrolę bezstronności.