
o1: model, który myśli przed odpowiedzią i wystawia za to rachunek
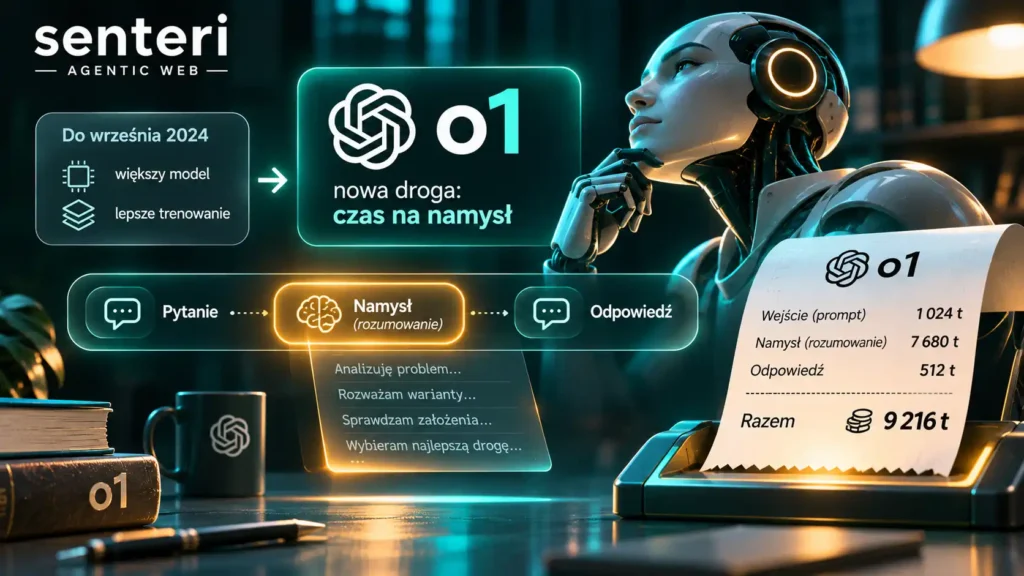
12 września 2024 OpenAI wypuściło model, który przed odpowiedzią milczał. Czasem kilka sekund, czasem minutę. W tym czasie pisał: rozważał podejścia, sprawdzał je, wycofywał się z błędnych. Tego pisania użytkownik nie widział. Widział tylko odpowiedź i rachunek, na którym te niewidoczne słowa były policzone jak każde inne.
o1 otworzył nową oś rozwoju modeli. Do tej pory lepszy model znaczył większy model albo lepiej wytrenowany. Od o1 lepszy może znaczyć także: taki, któremu pozwolono dłużej pomyśleć. Ta zmiana jest dziś wszędzie, w suwaku „wysiłku rozumowania” i w trybach Thinking. Ale zaczęła się od modelu, który był osobną linią, z osobną nazwą, i nawet tę nazwę wybrano, omijając cudzy znak towarowy.
Poprzednia część była o tym, jak model zaczął słyszeć. Ta jest o tym, jak zaczął się zastanawiać.
Kiedy
- 12 września 2024: o1-preview i o1-mini. Wewnętrznie model znano jako „Strawberry”. W API dostępny na start tylko dla kont, które wydały u OpenAI co najmniej tysiąc dolarów.
- Połowa września 2024: użytkownicy, którzy próbowali wyciągnąć z modelu jego ukryte rozumowanie, dostają od OpenAI maile z ostrzeżeniem o naruszeniu zasad.
- 5 grudnia 2024: pełny o1 i nowy abonament ChatGPT Pro za 200 dolarów miesięcznie, z trybem „o1 pro”, który myśli jeszcze dłużej.
- 20 grudnia 2024: zapowiedź o3. Nazwę o2 pominięto z powodu znaku towarowego sieci O2, o czym była mowa w pierwszej części.
- Początek lutego 2025: Deep Research w ChatGPT, agent badawczy zbudowany na o3, który przez kilkanaście minut przeszukuje sieć i pisze raport.
- 16 kwietnia 2025: o3 i o4-mini dla wszystkich płacących użytkowników.
Co odziedziczył
Wszystko, co było przed nim: pretrening, trening na posłuszeństwo, mechanizm generowania odpowiedzi token po tokenie, opisany w „Inference”. o1 nie jest nową architekturą. To model językowy, który przed odpowiedzią pisze sobie długi brudnopis.
Odziedziczył też pomysł, który krążył od lat: model rozwiązuje trudne zadania lepiej, kiedy rozpisze je krok po kroku. Ludzie od 2022 roku dopisywali do poleceń „pomyśl krok po kroku” i wyniki rosły. o1 przeniósł to z polecenia do treningu.
Co dostał nowego
Rozumowanie wytrenowane, a nie wyproszone. OpenAI uczyło model uczeniem ze wzmocnieniem, nagradzając za poprawne wyniki w zadaniach, które da się sprawdzić, jak matematyka czy programowanie. Model sam uczył się, jak prowadzić rozumowanie: próbować różnych strategii, zauważać własne błędy, rozbijać problem na części. Szczegółów nagród i danych OpenAI nie ujawniło.
Druga oś skali. Najważniejsze zdanie z ogłoszenia o1: wyniki rosną zarówno wraz z mocą obliczeniową użytą do treningu, jak i z czasem, który model dostaje na myślenie przy odpowiedzi. Do tej pory płaciło się głównie za trening. Teraz można było dokupić jakość przy każdym pytaniu.
Skok tam, gdzie wynik da się sprawdzić. W egzaminie matematycznym AIME 2024 GPT-4o rozwiązywał średnio 12 procent zadań. o1 przy jednej próbie 74 procent, a przy wyborze najczęstszej odpowiedzi z 64 prób 83 procent. W grudniu o3 w teście ARC-AGI, zbudowanym tak, żeby nie dało się go wykuć, uzyskał 75,7 procent, a przy znacznie większej mocy obliczeniowej 87,5 procent. Za cenę, która przy wersji tańszej wynosiła około 20 dolarów za jedno zadanie.
Do września 2024 jakość modelu kupowało się raz, przy treningu. Od o1 kupuje się ją przy każdym pytaniu.
Czego to nie rozwiązało
Przejrzystości. OpenAI postanowiło nie pokazywać surowego rozumowania. Oficjalny powód: nie chce pokazywać użytkownikom rozumowania, które nie zostało dopasowane do zasad. Drugi, przyznany wprost: przewaga konkurencyjna. Użytkownik widział streszczenie, a próby zajrzenia głębiej kończyły się ostrzeżeniem. Ironia: model, który miał być bardziej zrozumiały, bo „myśli na głos”, myślał na głos tylko dla swojego producenta. Pod presją konkurencji, o której w następnej części, OpenAI zaczęło na początku 2025 roku pokazywać dokładniejsze streszczenia rozumowania, ale surowy zapis pozostał ukryty.
Zmyślania. Rozumowanie nie wyleczyło halucynacji, a w niektórych testach je pogłębiło. Według karty systemowej OpenAI z kwietnia 2025 o3 zmyślał w odpowiedziach o ludziach w 33 procentach przypadków w teście PersonQA, dwa razy częściej niż o1, a o4-mini w 48 procentach. OpenAI przyznało, że nie zna przyczyny. Jedna z hipotez z samej karty: o3 formułuje po prostu więcej twierdzeń, więc ma więcej trafnych i więcej błędnych. Jak to wygląda w agencie, opisuje „Agent podaje dane, których nie ma”.
Przewidywalności kosztu. Płaci się za tokeny rozumowania, których nie widać, a ich liczba zależy od trudności pytania, czyli od czegoś, czego nie da się zmierzyć przed wysłaniem. OpenAI zalecało zostawić na samo rozumowanie około 25 tysięcy tokenów. To samo pytanie mogło kosztować kilka razy więcej niż wczoraj, bo model tym razem dłużej się zastanawiał.
Zastosowań, w których nie ma czego liczyć. Przewaga o1 była największa w matematyce, kodzie i nauce, gdzie odpowiedź da się sprawdzić. W pisaniu, rozmowie i prostych pytaniach model często tylko się spóźniał i drożej kosztował. Na starcie nie obsługiwał też narzędzi, obrazów ani promptu systemowego. Kiedy rozumowanie się opłaca, a kiedy za nie przepłacasz, opisuje „Modele rozumujące”.
Co to zmieniło dla stron i firm
Rachunek przestał być proporcjonalny do pytania. Do o1 dało się oszacować koszt z długości promptu i odpowiedzi. Od o1 największa część kosztu może leżeć w tokenach, których nie widać. Dla firmy, która płaci za API, to znaczy: budżet na myślenie trzeba ustawić świadomie, a koszt mierzyć po fakcie, w logach. Objaw, który pojawia się, kiedy tego nie zrobisz, ma nazwę: „Rachunek eksplodował, a nic się nie zmieniło”. Szerzej o tym, za co naprawdę się płaci, w „Nie płacisz za model”.
Czas odpowiedzi stał się parametrem. Model, który myśli minutę, nie nadaje się do czatu na stronie sklepu, ale może się nadawać do nocnej analizy faktur. Wybór modelu przestał być pytaniem „który lepszy”, a stał się pytaniem „ile mogę czekać i ile mogę zapłacić za to zadanie”.
Rozumowanie dało agentom plan. Model, który potrafi rozpisać zadanie na kroki, sprawdzić wynik i wrócić do błędu, to dokładnie to, czego potrzebuje pętla agenta, opisana w „Pętla od środka”. Deep Research z lutego 2025 był pierwszym masowym przykładem: agent, który sam planuje, czego szukać, czyta dziesiątki stron i pisze raport. OpenAI ostrzegało, że ma on trudność z odróżnieniem źródeł wiarygodnych od plotek.
Strony zyskały czytelnika, który czyta dokładnie. Agent badawczy nie ogląda strony głównej i nie wraca. Wchodzi w podstrony, porównuje źródła, szuka dat i liczb. Dla strony firmowej to nowa sytuacja: liczy się nie to, jak treść wygląda, tylko czy da się ją jednoznacznie przeczytać, zacytować i sprawdzić. To jeden z powodów, dla których senteri pisze o tym, jak maszyny czytają sieć.
Jedna myśl na drogę
o1 dał modelom czas do namysłu i zamknął ten namysł w czarnej skrzynce, za którą trzeba było płacić bez wglądu. Cztery miesiące później chińskie laboratorium pokazało model, który myślał podobnie, myślał na głos dla każdego i dało się go pobrać za darmo. W następnej części: DeepSeek R1 i tydzień, w którym giełda przestraszyła się otwartego modelu.
Źródła
- o1-preview i o1-mini: tokeny rozumowania, ograniczenia na starcie, powody ukrycia rozumowania (Simon Willison, 12 września 2024)
- OpenAI, „Learning to Reason with LLMs”: wyniki AIME i dwie osie skali (omówienie w WorkOS)
- o1: co wiadomo o treningu i czego nie ujawniono (Paper Notes)
- OpenAI ostrzega użytkowników badających rozumowanie o1 (eDiscovery Today, 18 września 2024)
- Pełny o1 i ChatGPT Pro za 200 dolarów (TechCrunch, 5 grudnia 2024)
- o3 i wyniki w ARC-AGI wraz z kosztem zadania (The Decoder, grudzień 2024)
- Deep Research: agent badawczy na o3 i jego ograniczenia (The Register, 3 lutego 2025)
- o3 i o4-mini zmyślają częściej niż poprzednicy, dane z karty systemowej (Techzine, kwiecień 2025)