
Długi kontekst: zmieścić nie znaczy przeczytać
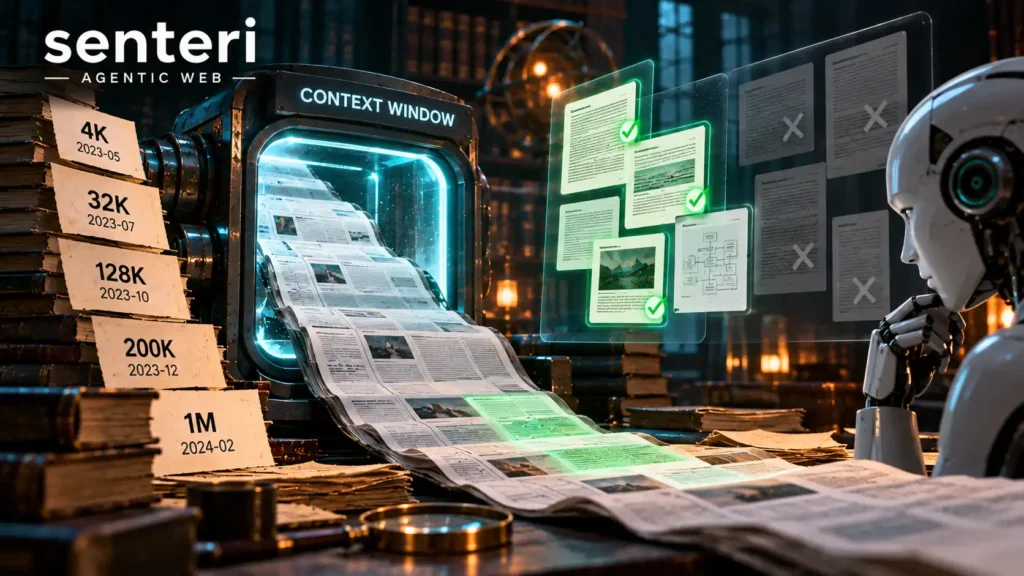
Od maja 2023 do lutego 2024 okno kontekstu urosło z kilku tysięcy do miliona tokenów. Przez ten sam czas kolejne badania pokazywały, że to, co mieści się w oknie, nie zawsze trafia do odpowiedzi.
W maju 2023 Anthropic wczytało do Claude całego „Wielkiego Gatsby’ego” ze zmienionym jednym zdaniem i zapytało, co jest nie tak. Model znalazł zmianę w 22 sekundy. Okno kontekstu urosło właśnie z 9 do 100 tysięcy tokenów, a pokaz miał udowodnić, że model nie tylko mieści książkę, ale ją czyta.
Przez następny rok liczba w oknie rosła szybciej niż jakakolwiek inna: 128 tysięcy w GPT-4 Turbo, 200 tysięcy w Claude 2.1, milion w Gemini 1.5 Pro, dziesięć milionów w testach Google. I przez ten sam rok kolejne badania pokazywały, że zmieścić nie znaczy przeczytać. To przejście jest o tej różnicy.
Poprzednia część była o tym, gdzie model mieszka. Ta jest o tym, ile naraz potrafi trzymać przed oczami i ile z tego naprawdę widzi.
Kiedy
- 11 maja 2023: Claude z oknem 100 tysięcy tokenów, czyli około 75 tysięcy słów. Wcześniej 9 tysięcy.
- 6 lipca 2023: praca „Lost in the Middle” badaczy ze Stanfordu i współpracujących ośrodków: modele najlepiej korzystają z informacji na początku i na końcu długiego tekstu, a najgorzej ze środka.
- 6 listopada 2023: GPT-4 Turbo z oknem 128 tysięcy tokenów.
- 21 listopada 2023: Claude 2.1 z oknem 200 tysięcy tokenów, czyli kilkuset stron, a przy okazji z promptem systemowym i pierwszą wersją korzystania z narzędzi.
- 15 lutego 2024: Gemini 1.5 Pro. Standardowo 128 tysięcy tokenów, a dla wybranych firm milion, czyli według Google około godziny wideo, 11 godzin nagrań albo ponad 700 tysięcy słów.
- 14 sierpnia 2024: Anthropic wprowadza zapisywanie początku promptu w pamięci podręcznej. Długi kontekst, który powtarza się w kolejnych zapytaniach, staje się do 90 procent tańszy.
Co odziedziczył
Ten sam mechanizm uwagi, w którym każdy token „patrzy” na każdy wcześniejszy. To on sprawia, że dłuższe okno nie jest za darmo: pamięć i obliczenia rosną razem z długością, a przy podstawowej wersji mechanizmu rosną szybciej niż sama długość. Szczegóły opisuje „Dlaczego długi kontekst jest drogi”.
Odziedziczył też to, czym model w ogóle jest. Okno kontekstu to nie pamięć, tylko tekst, który model czyta przy każdej odpowiedzi od nowa. Milion tokenów to milion tokenów do przeczytania za każdym razem, z rachunkiem za każdym razem.
Co dostał nowego
Skala, której wcześniej nie było. W ciągu dziewięciu miesięcy okno udostępniane firmom urosło ponad stukrotnie, od kilku tysięcy do miliona tokenów. Do modelu dało się wrzucić całą umowę z załącznikami, całą dokumentację systemu, raport roczny, a w przypadku Gemini także godzinę nagrania wideo.
Uczenie się z samego tekstu w oknie. Najbardziej poruszający pokaz Gemini 1.5 dotyczył kalamang, języka, którym posługuje się mniej niż dwieście osób na świecie. Google wczytało do kontekstu podręcznik gramatyki tego języka i model tłumaczył z angielskiego na kalamang mniej więcej tak dobrze jak człowiek uczący się z tych samych materiałów. Bez żadnego dotrenowania: cała „nauka” zmieściła się w jednym zapytaniu.
Nowa architektura pod spodem. Gemini 1.5 był zbudowany jako mieszanka ekspertów: przy każdym tokenie pracuje tylko część modelu. Google przedstawiło to jako sposób na tańszy trening i obsługę. Ten sam wzór, zapisany jako A3B w nazwie Qwena, opisała pierwsza część.
Testy „igły w stogu siana”. Greg Kamradt, niezależny programista, ukrył jedno zdanie w długim tekście i sprawdzał, czy model je znajdzie, na różnych głębokościach i przy różnej długości okna. Wykres w formie mapy cieplnej stał się standardem. Google chwaliło się, że Gemini 1.5 Pro znajduje igłę w 99 procentach przypadków przy milionie tokenów.
Czego to nie rozwiązało
Środek tekstu. Praca „Lost in the Middle” pokazała to, zanim okna przekroczyły 100 tysięcy: model najlepiej wykorzystuje informacje z początku i z końca, a wyraźnie gorzej ze środka, także modele projektowane do długich tekstów. Test Kamradta na Claude 2.1 dał podobny obraz: zdania z samej góry i samego dołu model znajdował prawie zawsze, w środku gorzej, a na samym dole zaczynał tracić skuteczność od około 90 tysięcy tokenów.
Zachowanie modelu. Najciekawsza historia tego przejścia. W teście Anthropic Claude 2.1 znajdował wstawione zdanie tylko w 27 procentach przypadków. Wyjaśnienie nie dotyczyło pamięci, tylko charakteru: model był trenowany, żeby nie odpowiadać na podstawie pojedynczego zdania, które nie pasuje do reszty dokumentu. A „igła” z definicji nie pasuje. Wystarczyło dopisać na początku odpowiedzi modelu zdanie „Oto najistotniejsze zdanie z kontekstu:”, żeby wynik wzrósł do 98 procent. Model miał informację w oknie przez cały czas. Nie chciał jej użyć.
Test igły sprawdza, czy model znajdzie zdanie, które nie pasuje. Prawdziwa praca polega na połączeniu wielu zdań, które pasują.
Rozumienie całości. Znalezienie jednego wstawionego zdania to najłatwiejsze zadanie, jakie można dać modelowi z długim kontekstem. Porównanie dwóch wersji umowy, wyłapanie sprzeczności między załącznikami czy streszczenie dokumentacji to zupełnie inna praca. W lipcu 2025 Chroma opublikowała badanie nazwane „context rot”: skuteczność modeli zmienia się wyraźnie wraz z długością wejścia, nawet przy prostych zadaniach. Praktyczne skutki opisuje „Okno kontekstu, budżet tokenów i context rot”.
Czas i rachunek. Zanim model napisze pierwsze słowo odpowiedzi, musi przeczytać całe okno. Przy milionie tokenów trwa to długo i kosztuje za każdym razem tyle samo, o ile nie ma pamięci podręcznej. Dlaczego pierwszy token czeka tak długo, opisuje „Pierwszy token i cała reszta”.
Agenci. W długim zadaniu agent sam wypełnia swoje okno: wynikami narzędzi, poprzednimi krokami, błędami. Im dłużej pracuje, tym bardziej przypomina model, któremu dano milion tokenów i ważną informację w środku. Tak wygląda objaw z „Agent gubi wątek w długim zadaniu”.
Co to zmieniło dla stron i firm
Spór „wrzuć wszystko” kontra „wybierz, co trzeba”. Długie okno obiecywało koniec wyszukiwania fragmentów: po co budować wyszukiwarkę dokumentów, skoro można dać modelowi całość. Ten spór trwa do dziś i kończy się zwykle kompromisem: długie okno na to, co trzeba czytać w całości, wyszukiwanie fragmentów na resztę. Obie strategie porównuje „Retrieval jako składanie kontekstu”, a to, jak agent ma porządkować własne okno, „Kompaktowanie kontekstu”.
Pamięć podręczna zmieniła ekonomię. Jeśli każde zapytanie zaczyna się od tej samej instrukcji, cennika czy dokumentacji, nie trzeba za nią płacić pełnej ceny za każdym razem. W teście Anthropic rozmowa z książką o 100 tysiącach tokenów przy zapisanym kontekście zaczynała się po 2,4 sekundy zamiast 11,5. Od tej chwili kolejność elementów w prompcie ma znaczenie finansowe: to, co stałe, idzie na początek. Mechanizm opisuje „Prompt caching”.
Strony zaczęły myśleć o tym, jak je przeczyta model. Skoro model może przeczytać całą dokumentację naraz, ktoś musi mu ją podać w strawnej formie. We wrześniu 2024 Jeremy Howard zaproponował plik llms.txt, czyli krótki spis najważniejszych treści strony w formacie dla modeli. Przyjął się głównie w dokumentacjach dla programistów. Według analiz z 2025 roku duże usługi AI go nie sprawdzały, więc to raczej gest wobec narzędzi programistycznych niż standard. Ale kierunek jest ten sam, o którym pisze senteri: treść zaczyna mieć dwóch czytelników.
Długi dokument przestał być barierą. Dla firmy z ERP to konkret: umowa ramowa z załącznikami, instrukcja stanowiskowa, eksport ustawień systemu mieszczą się w jednym zapytaniu. Tyle że, jak pokazał Claude 2.1, to, że coś jest w oknie, nie znaczy, że model tego użyje. Ważne rzeczy warto podać na początku albo na końcu i zapytać o nie wprost.
Jedna myśl na drogę
Długość okna to pojemność, a nie uwaga. Liczba w specyfikacji mówi, ile da się do modelu wrzucić, a nie ile z tego model naprawdę weźmie pod uwagę. Ta różnica jest dziś jednym z głównych tematów budowania agentów.
W następnej części: GPT-4o, czyli moment, w którym model zaczął słyszeć i mówić bez pośredników, a obraz, dźwięk i tekst trafiły do jednego modelu.
Źródła
- Claude 100K: test na „Wielkim Gatsbym” (TechCrunch, 11 maja 2023)
- Liu i in., „Lost in the Middle: How Language Models Use Long Contexts” (arXiv, lipiec 2023)
- Claude 2.1: 200 tysięcy tokenów i test Grega Kamradta (InfoQ, listopad 2023)
- Claude 2.1: wyjaśnienie wyniku testu i poprawka w prompcie, 27% → 98% (Simon Willison)
- Claude 2.1: opis z wyjaśnieniem Anthropic (AI Wiki)
- Google, „Our next-generation model: Gemini 1.5” (15 lutego 2024)
- Gemini 1.5 uczy się języka kalamang z podręcznika gramatyki (BGR)
- Anthropic wprowadza zapisywanie promptu w pamięci podręcznej (SD Times, 14 sierpnia 2024)
- Chroma, „Context Rot” (lipiec 2025, repozytorium badania)
- llms.txt: propozycja i stan przyjęcia (AI Wiki)