
Model gubi środek kontekstu
Wkleiłeś umowę z aneksami i zapytałeś o termin płatności. Model odpowiedział pewnie i według umowy, a nie według aneksu, który ten termin zmienił. Aneks był w oknie. To, że coś się zmieściło, nie znaczy, że zostało przeczytane.
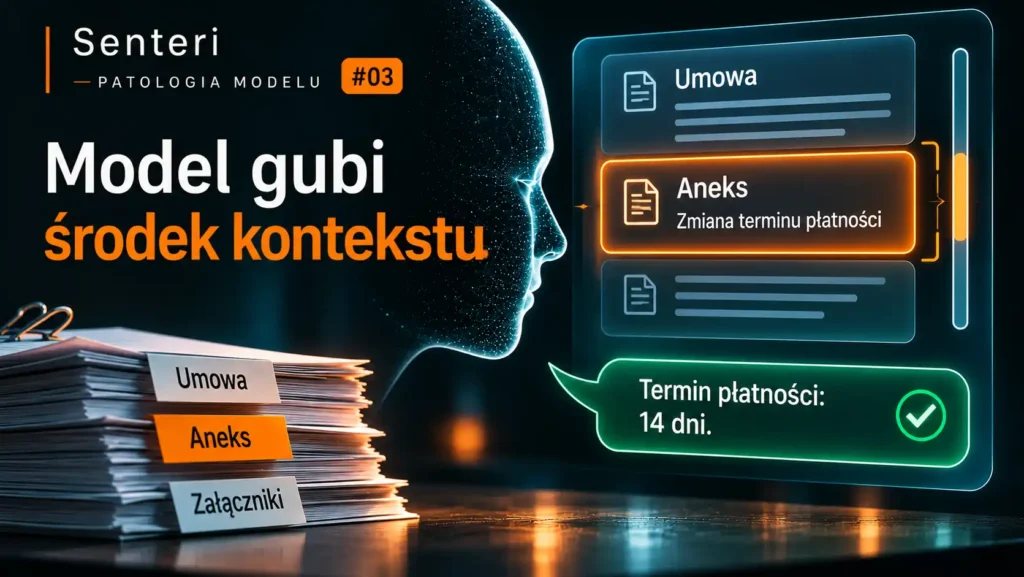
Kierowniczka działu zakupów wkleja do czatu umowę ramową z dostawcą: sześćdziesiąt stron i trzy aneksy. Pyta, jaki jest termin płatności. Model odpowiada, że 30 dni, i wskazuje paragraf 7. Odpowiedź jest konkretna i zgodna z umową. Jest też błędna, bo aneks nr 2, wklejony gdzieś w środku, zmienił ten termin na 45 dni.
Model niczego tu nie zmyślił. Paragraf 7 istnieje i mówi dokładnie to, co model przytoczył. Aneks też był w oknie przez cały czas. Model po prostu z niego nie skorzystał.
Jak okno kontekstu rosło od kilku tysięcy do miliona tokenów i dlaczego „zmieścić” nie znaczy „przeczytać”, opisuje piąta część Genealogii. Ta część jest o samym objawie: jak go rozpoznać, z czym go pomylić i co z nim zrobić. Spełnia warunek tej serii, bo wystarczy jedno długie wklejenie i jedno pytanie, bez narzędzi i bez pętli.
Objaw
Ten objaw ma cztery twarze. W praktyce często występują razem.
Liczy się miejsce. W 2023 roku badacze ze Stanfordu dawali modelom dwadzieścia dokumentów, z których tylko jeden zawierał odpowiedź, i przesuwali go od początku do końca. Wyniki układały się w literę U: najlepiej, gdy właściwy dokument był pierwszy albo ostatni, najgorzej, gdy był w środku. W najgorszym przypadku GPT-3.5 z odpowiedzią w środku wypadał gorzej niż bez żadnych dokumentów, czyli poniżej 56,1%, które osiągał, odpowiadając z pamięci. Dołożenie właściwego dokumentu w złe miejsce pogorszyło wynik.
Liczy się sama długość. W październiku 2025 zespół z Uniwersytetu Illinois i współpracujących ośrodków sprawdził rzecz bardziej niepokojącą. Dawał modelom zadania z matematyki, wiedzy ogólnej i programowania, a potem wydłużał wejście tekstem bez znaczenia. Modele potrafiły bezbłędnie przytoczyć potrzebne fragmenty, a mimo to ich wyniki spadały o 13,9% do 85%, choć wejście było dużo krótsze, niż deklarowali producenci. Spadek pojawiał się nawet wtedy, gdy zbędny tekst zastąpiono spacjami i gdy wszystkie potrzebne informacje stały tuż przed pytaniem. Sama długość szkodzi, niezależnie od tego, czy model znalazł to, czego szukał.
Mylą go fragmenty podobne, ale nie te. Popularny test „igły w stogu siana” sprawdza, czy model znajdzie wstawione zdanie. Badacze z Adobe zauważyli w 2025 roku, że w takich testach pytanie zwykle używa tych samych słów co szukane zdanie, więc model może dopasować słowa, zamiast rozumieć. Zbudowali wersję testu bez wspólnych słów. Przy 32 tysiącach tokenów, czyli kilkudziesięciu stronach, dziesięć z dwunastu modeli spadło poniżej połowy wyniku, który osiągały na krótkim tekście. GPT-4o spadł z 99,3% do 69,7%. Badanie Chroma z lipca 2025 na osiemnastu modelach, w tym GPT-4.1, Claude 4, Gemini 2.5 i Qwen3, pokazało drugą stronę tego samego: fragmenty podobne do szukanego, ale błędne, szkodzą tym bardziej, im dłuższe jest wejście. Umowa i aneks, cennik z 2025 i 2026 roku, dwie wersje regulaminu to właśnie takie fragmenty.
Gubi się w długiej rozmowie. Rozmowa w czacie to też kontekst, który rośnie z każdą wymianą. Badacze z Microsoft Research i Salesforce przeprowadzili ponad 200 tysięcy symulowanych rozmów z piętnastoma modelami. Polecenie podawali w kawałkach, tak jak robią to ludzie, którzy doprecyzowują, czego chcą. Skuteczność spadła średnio o 39% w porównaniu z tym samym poleceniem podanym od razu w całości. Spadek pojawiał się już przy dwóch wymianach i dotyczył wszystkich modeli, od małych otwartych po czołowe. Autorzy opisali to tak: gdy model raz źle skręci w rozmowie, gubi się i nie wraca na właściwą drogę. Ta praca dostała wyróżnienie dla najlepszych prac na konferencji ICLR 2026.
Każdy token, który dokładasz, kosztuje dwa razy: raz w rachunku i drugi raz w uwadze modelu.
Skąd się bierze
Odpowiedź jest częściowa, bo mechanizm nie jest do końca wyjaśniony. Badania dobrze opisują, kiedy objaw się pojawia, a mniej o tym, dlaczego. Wiadomo jednak kilka rzeczy.
Uwaga modelu ma wbudowane skrzywienie. Praca z 2024 roku, w której brali udział badacze Google, pokazała, że modele przypisują więcej uwagi tokenom na początku i na końcu wejścia niezależnie od ich treści. Model zauważa ważny fragment w środku, ale początek i koniec odciągają od niego uwagę. Krzywa U nie jest więc skutkiem tego, że model nie widzi środka. Wynika z tego, że środek przegrywa z brzegami.
Uwaga rozkłada się na wszystko. W mechanizmie uwagi każdy token „patrzy” na wszystkie wcześniejsze. Im więcej tokenów, tym mniejsza część uwagi przypada na każdy z nich, także na te ważne. To tłumaczy, dlaczego szkodzi nawet tekst bez znaczenia: nie wprowadza w błąd, ale rozcieńcza.
Trening wygląda inaczej niż praca. Modele uczą się głównie na krótkich tekstach i na rozmowach, w których polecenie pada w całości na początku. Długie wejścia w treningu bywają syntetyczne, a test igły łatwo zaliczyć dopasowaniem słów. Autorzy pracy o rozmowach wprost wskazują rozdźwięk między tym, jak modele się trenuje i ocenia, a tym, jak ludzie z nich korzystają.
Z czym to pomylić
Ze zmyślaniem. Jeśli odpowiedzi nie ma w żadnym miejscu wklejonego tekstu, model ją zmyślił. Jeśli jest, ale w niewłaściwej wersji albo z niewłaściwego miejsca, model zgubił właściwy fragment. Rozróżnia je prośba o cytat i miejsce: paragraf, stronę, nazwę pliku. Prawdziwy cytat z niewłaściwego miejsca oznacza zgubienie. Cytat, którego nie ma w tekście, oznacza zmyślenie.
Z obcięciem. Aplikacje czatu i systemy z wyszukiwaniem fragmentów nie zawsze przekazują modelowi cały wklejony tekst. Przycinają go albo wybierają tylko część. Wtedy model nie zgubił aneksu, bo nigdy go nie dostał. Prosty test: zapytaj o coś z ostatniej strony. Jeśli model nie wie, co tam jest, problem leży przed modelem, nie w nim.
Z objawem agenta. Agent w długim zadaniu sam wypełnia swoje okno wynikami narzędzi, poprzednimi krokami i błędami. Po godzinie pracy jest w sytuacji kierowniczki z umową, tylko nikt tego nie widzi. Ten objaw opisuje „Agent gubi wątek w długim zadaniu”. Mechanizm jest ten sam, piętro niżej. Różnica polega na tym, kto zapełnił okno: człowiek jednym wklejeniem czy agent krok po kroku.
Co da się zrobić po stronie pytania
- Wklejaj mniej. Tylko to, co obowiązuje. Stara wersja umowy, nieaktualny cennik i poprzedni regulamin to nie kontekst, tylko pułapki. Jeśli aneks zmienia umowę, lepiej dać modelowi tekst jednolity albo sam aneks z jednym paragrafem, który zmienia.
- Ważne na początek albo na koniec. Jeśli coś musi zostać uwzględnione, nie zostawiaj tego w środku. Pytanie postaw po dokumencie, nie przed nim.
- Najpierw cytaty, potem odpowiedź. Poproś model, żeby najpierw przytoczył fragmenty potrzebne do odpowiedzi, z podaniem miejsca, a dopiero potem odpowiedział na ich podstawie. Autorzy pracy z 2025 roku pokazali, że takie „zamienienie długiego zadania na krótkie” poprawia wyniki. Masz też od razu coś, co da się sprawdzić.
- Jedno pytanie zamiast „sprawdź wszystko”. „Czy w tych dokumentach są sprzeczności?” to zadanie, przy którym długie wejście szkodzi najbardziej. Lepiej pytać o konkretne rzeczy po kolei: termin płatności, kary, okres wypowiedzenia.
- Gdy rozmowa się rozjechała, zacznij od nowa. W badaniu o rozmowach to samo polecenie podane od razu w całości dawało wynik bliski pełnemu. Jeśli po dziesięciu doprecyzowaniach model wciąż robi nie to, nie dopisuj jedenastego. Zbierz wszystkie ustalenia w jedno polecenie i otwórz nową rozmowę.
- Sprawdź na własnym dokumencie. Weź typowy dla siebie dokument, wstaw w środek fakt, który znasz, i zapytaj o niego innymi słowami, niż jest zapisany. Tak sprawdzisz, od jakiej długości twój model przestaje być wiarygodny w twojej pracy. Liczba z karty modelu tego nie powie.
Czego nie da się zrobić
Zaufać liczbie w specyfikacji. Okno w milionie tokenów mówi, ile da się wkleić, a nie ile model weźmie pod uwagę. W badaniach opisanych wyżej wyraźne spadki pojawiały się już przy kilku do kilkudziesięciu tysięcy tokenów, daleko od deklarowanych granic.
Ufać wynikom testu igły. Model, który znajduje wstawione zdanie w milionie tokenów, zalicza najłatwiejszą wersję zadania. Praca w firmie polega zwykle na czymś trudniejszym: połączeniu kilku fragmentów, rozpoznaniu, który z dwóch podobnych obowiązuje, albo zauważeniu, że czegoś brakuje.
Liczyć, że model powie, czego nie doczytał. Odpowiedź, w której zabrakło aneksu, wygląda tak samo jak pełna. Model nie zgłasza, że jego uwaga ominęła środek. O tym, że coś pominął, dowiesz się dopiero, gdy sam sprawdzisz.
Załatwić tego samym poleceniem. „Przeczytaj uważnie cały dokument” nie zmienia rozkładu uwagi. W pracy z 2025 roku wyniki spadały nawet wtedy, gdy zbędne tokeny całkowicie zamaskowano i model mógł patrzeć tylko na właściwe. Pomaga krótszy tekst, a nie grzeczniejsza prośba.
Jedna myśl na drogę
Długi kontekst kusi, bo zwalnia z decyzji, co jest ważne: wklejasz wszystko i niech model sam wybierze. Tę decyzję i tak ktoś podejmuje. Jeśli nie zrobisz tego ty, zrobi to rozkład uwagi modelu, który faworyzuje początek i koniec, a nie to, co obowiązuje. Najlepszy kontekst to najkrótszy kontekst, w którym jest wszystko, co potrzebne.
W następnej części: model, który słucha tekstu, który miał tylko przeczytać, czyli co się dzieje, gdy w oknie obok dokumentu pojawia się polecenie, którego nie napisałeś ty.
Źródła
- Liu i in., „Lost in the Middle: How Language Models Use Long Contexts” (Stanford, arXiv 2023, TACL 2024)
- Hsieh i in., „Found in the Middle: Calibrating Positional Attention Bias Improves Long Context Utilization” (arXiv, 2024)
- Du i in., „Context Length Alone Hurts LLM Performance Despite Perfect Retrieval” (arXiv, 6 października 2025)
- Modarressi i in., „NoLiMa: Long-Context Evaluation Beyond Literal Matching” (Adobe Research i LMU, ICML 2025)
- Hong, Troynikov, Huber, „Context Rot: How Increasing Input Tokens Impacts LLM Performance” (Chroma, 14 lipca 2025)
- Laban, Hayashi, Zhou, Neville, „LLMs Get Lost In Multi-Turn Conversation” (Microsoft Research i Salesforce Research, ICLR 2026)