
DeepSeek R1: rozumowanie, które dało się pobrać
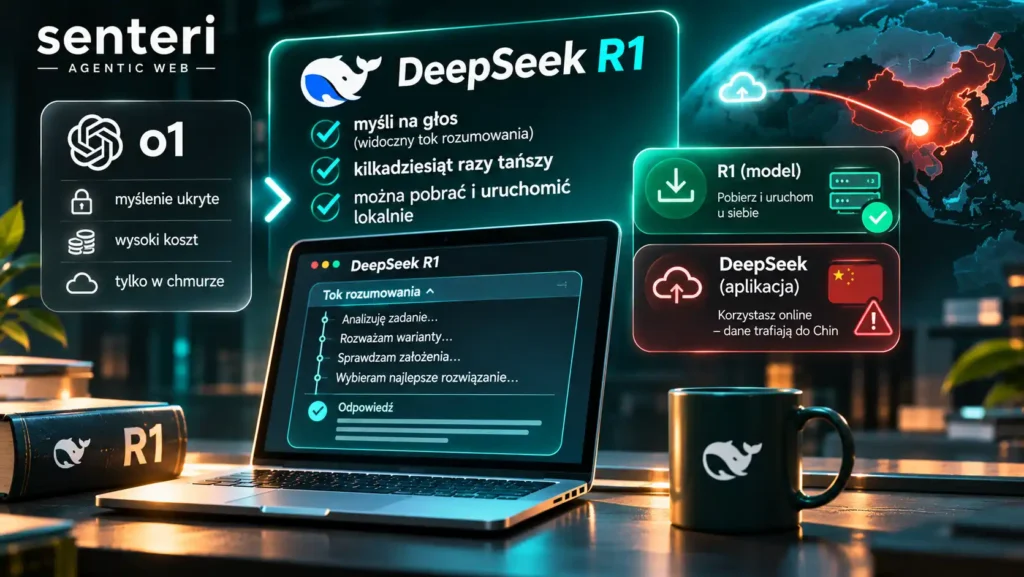
o1 ukrył swoje myślenie i liczył za nie słono. R1 myślał na głos dla każdego, był kilkadziesiąt razy tańszy i dało się go pobrać. Przy okazji pokazał, że jedna nazwa może oznaczać plik, który bezpiecznie uruchomisz u siebie, i aplikację, która wysyła dane do Chin.
27 stycznia 2025 akcje Nvidii spadły na zamknięciu o prawie 17 procent. Spółka straciła w jeden dzień około 589 miliardów dolarów wartości, najwięcej w historii giełdy. Powodem nie był nowy procesor konkurencji ani wynik kwartalny, tylko model językowy z Hangzhou, opublikowany tydzień wcześniej z licencją MIT.
DeepSeek R1 zrobił z rozumowaniem to, co Llama zrobiła z modelami czatowymi. o1 pokazał, że model może myśleć przed odpowiedzią, ale ukrył to myślenie i liczył za nie jak za złoto. R1 myślał na głos dla każdego, kosztował w API kilkadziesiąt razy mniej i dało się go pobrać. A przy okazji pokazał, że jedna nazwa może oznaczać dwie zupełnie różne rzeczy: plik, który uruchomisz bezpiecznie u siebie, i aplikację, która wysyła twoje dane do Chin.
Kiedy
- 25–26 grudnia 2024: DeepSeek-V3, duży model w architekturze mieszanki ekspertów, z otwartymi wagami. Według raportu technicznego ostatni etap treningu zajął około 2,8 miliona godzin pracy kart H800, szacowanych na 5,6 miliona dolarów.
- 20 stycznia 2025: DeepSeek-R1, model rozumujący zbudowany na V3, na licencji MIT. Razem z nim sześć mniejszych modeli „wydestylowanych” z R1 i oficjalna zgoda na używanie jego odpowiedzi do trenowania innych modeli.
- 27 stycznia 2025: aplikacja DeepSeek na szczycie sklepów z aplikacjami, wyprzedaż akcji spółek technologicznych.
- 29 stycznia 2025: firma Wiz ujawnia, że baza danych DeepSeek z ponad milionem wpisów, w tym historią rozmów i kluczami API, była dostępna w internecie bez hasła. Tego samego dnia test PromptFoo: R1 odmawia odpowiedzi na około 85 procent z 1360 pytań o tematy drażliwe dla chińskich władz.
- Koniec stycznia 2025: włoski urząd ochrony danych blokuje aplikację DeepSeek we Włoszech.
- 6 lutego 2025: OpenAI zaczyna pokazywać dokładniejsze streszczenia rozumowania o3-mini. Według TechCrunch to odpowiedź na presję m.in. ze strony DeepSeeka.
- 7 lutego 2025: polski UODO zaleca „daleko idącą ostrożność” w korzystaniu z DeepSeek.
- 17 września 2025: praca o R1 w „Nature”, prawdopodobnie pierwszy duży model językowy, który przeszedł recenzję naukową.
Co odziedziczył
Pomysł od o1: model, który dostaje czas na rozumowanie i jest za dobre rozumowanie nagradzany w zadaniach, które da się sprawdzić. DeepSeek nie wymyślił kierunku, tylko pokazał, że da się nim pójść bez dostępu do sekretów OpenAI.
Fundament od V3: około 670 miliardów parametrów, z czego przy każdym tokenie pracuje tylko niewielka część, oraz długą listę oszczędności w treningu opisanych w raporcie technicznym. Ten sam rodzaj architektury co Gemini 1.5 z części piątej i ta sama logika, która później dała DeepSeekowi V4-Pro i V4-Flash z części pierwszej.
I tradycję otwartych wag, opisaną w części czwartej, tylko z licencją bardziej otwartą niż Llama: MIT, bez progów dla dużych firm i z wprost wyrażoną zgodą na destylację.
Co dostał nowego
Rozumowanie z samego wzmocnienia. Najciekawszy był nie R1, tylko jego wcześniejsza wersja, R1-Zero. Badacze trenowali ją wyłącznie przez nagradzanie poprawnych wyników, bez pokazywania, jak ma wyglądać dobre rozumowanie. Model sam zaczął wydłużać tok myślenia, sprawdzać się i wracać do błędów; autorzy opisali w pracy moment, w którym model „zauważa” własną pomyłkę i zaczyna od nowa. R1-Zero pisał przy tym chaotycznie i mieszał języki, więc wersja publiczna dostała jeszcze dawkę klasycznego dotrenowania.
Myślenie na głos. R1 pokazywał całe swoje rozumowanie, w aplikacji i w API. Dla badaczy i programistów to była różnica jakościowa: można było zobaczyć, gdzie model zboczył z drogi, zamiast zgadywać z odpowiedzi.
Cena. W API R1 kosztował 0,55 dolara za milion tokenów wejścia i 2,19 dolara za milion tokenów wyjścia. o1 kosztował w tym czasie 15 i 60 dolarów. Różnica rzędu 27 razy, przy wynikach, które DeepSeek określał jako porównywalne z o1 w matematyce, kodzie i rozumowaniu.
Małe modele z rozumowaniem. Sześć wydestylowanych modeli, zbudowanych na mniejszych otwartych modelach, przeniosło styl rozumowania R1 na mniejsze rozmiary, od 1,5 do 70 miliardów parametrów, w tym takie, które działają na zwykłym komputerze. Według DeepSeeka największe z nich wypadały na poziomie o1-mini. Czym jest destylacja i ile się na niej traci, opisuje „Rozmiar, kwantyzacja, destylacja”.
o1 pokazał, że model może myśleć. R1 pokazał, że to myślenie nie jest niczyją własnością.
Czego to nie rozwiązało
Mitu taniego modelu. Liczba 5,6 miliona dolarów obiegła świat jako koszt zbudowania modelu, który dorównał OpenAI. Tymczasem dotyczyła tylko ostatniego etapu treningu V3, bez wcześniejszych badań, eksperymentów i sprzętu. W pracy w „Nature” DeepSeek podał, że sam trening R1 kosztował około 294 tysięcy dolarów, na fundamencie modelu bazowego za mniej więcej 6 milionów. To wciąż mało w porównaniu z konkurencją, ale nie jest to cena całego laboratorium.
Sporu o to, na czym się uczył. W styczniu media donosiły, że OpenAI podejrzewa DeepSeek o trenowanie na odpowiedziach jego modeli. DeepSeek odpowiedział recenzentom „Nature”, że R1 nie kopiował rozumowania wygenerowanego przez OpenAI, ale przyznał, że dane z sieci, na których uczył się model bazowy, mogą zawierać tekst napisany przez AI. Danych treningowych nie opublikował.
Cenzury. Model z Chin odpowiada według chińskich zasad. Test PromptFoo pokazał odmowę przy około 85 procentach pytań o tematy drażliwe dla władz w Pekinie, często z nacjonalistycznym tonem zastępczej odpowiedzi. Otwarte wagi nie zmieniają tego, czego model się nauczył; zmieniają tylko to, że można to zbadać.
Bezpieczeństwa usługi. Otwarta baza danych z historią rozmów, znaleziona przez Wiz w ciągu kilku minut szukania, to błąd na poziomie podstaw. Dobry model nie gwarantuje dobrej infrastruktury wokół niego.
Co to zmieniło dla stron i firm
Model i usługa to dwie różne decyzje. To najważniejsza lekcja tej części, kontynuacja tego, o czym pisała pierwsza część: nazwa produktu to nie nazwa modelu. „Używamy DeepSeeka” może znaczyć, że pracownik wkleja umowę do chińskiej aplikacji, której polityka prywatności przewiduje przechowywanie danych w Chinach. Może też znaczyć, że firma uruchamia pobrane wagi na własnym serwerze i żaden bajt nie opuszcza budynku. Komunikat UODO dotyczył pierwszego przypadku. Drugi to sytuacja z części czwartej: plik na dysku, z odpowiedzialnością po twojej stronie. Gdzie dokładnie wykonuje się model, opisuje „Gdzie wykonuje się model”.
Rozumowanie stało się tanie. Po R1 nikt już nie mógł sprzedawać samego „modelu, który myśli” jako czegoś wyjątkowego. Ceny spadały, OpenAI udostępniło o3-mini także darmowym użytkownikom i zaczęło pokazywać więcej z rozumowania. Dla firmy, która płaci za API, to dobra wiadomość, z jednym zastrzeżeniem z części siódmej: tani token rozumowania nadal może dać drogi rachunek, jeśli model myśli długo.
Chiny weszły do czołówki. Do stycznia 2025 rozmowa o najlepszych modelach toczyła się prawie wyłącznie wokół amerykańskich laboratoriów. Po R1 do tej rozmowy na stałe weszli DeepSeek, Qwen i inni. Dla Europy to dodatkowa warstwa decyzji: nie tylko który model jest dobry, ale też czyje prawo obowiązuje dostawcę i gdzie trafiają dane.
Otwarty model można sprawdzić. Cenzurę w R1 zbadano i opisano właśnie dlatego, że wagi są dostępne. Tak samo zbadano, jak obejść ją przez dotrenowanie. Przy modelu zamkniętym takie badanie zależy od dobrej woli producenta. To argument za otwartymi wagami, nawet gdy pochodzą od dostawcy, któremu nie ufasz.
Jedna myśl na drogę
R1 to pierwszy model, przy którym trzeba było jednocześnie powiedzieć „to przełom” i „uważaj, gdzie wpisujesz dane”. Obie rzeczy były prawdą. Lekcja dla firm jest prosta: nie oceniaj modelu po nazwie, tylko po tym, gdzie działa, kto ma dostęp do tego, co mu powiesz, i czy możesz to sprawdzić.
W następnej części cofamy się o kilka miesięcy, do października 2024: Claude 3.5 Sonnet dostaje możliwość obsługi komputera, czyli moment, w którym model przestaje tylko odpowiadać i zaczyna działać.
Źródła
- DeepSeek, „DeepSeek-R1 Release” (20 stycznia 2025): licencja MIT, destylacja, ceny API
- DeepSeek-V3: data, skala treningu, szacowany koszt (Simon Willison, 26 grudnia 2024)
- Nvidia traci 589 mld dolarów wartości w jeden dzień (Tom’s Hardware, 28 stycznia 2025)
- Wiz: otwarta baza danych DeepSeek z historią rozmów (The Register, 30 stycznia 2025)
- R1 odmawia odpowiedzi na 85% pytań o tematy drażliwe dla Chin, test PromptFoo (TechCrunch, 29 stycznia 2025)
- Włoski Garante blokuje aplikację DeepSeek (PPE.pl, 29 stycznia 2025)
- UODO zaleca ostrożność w korzystaniu z DeepSeek (Rzeczpospolita, 7 lutego 2025)
- OpenAI pokazuje więcej z rozumowania o3-mini (TechCrunch, 6 lutego 2025)
- Praca o R1 w „Nature”: koszt treningu, recenzja, odpowiedź na zarzuty o destylację (Scientific American, 17 września 2025)